12 Min. Lesezeit
Das gesperrte Holdout, das ich zweimal laufen lassen musste – und warum beide Läufe öffentlich sind
Mein gesperrtes Testset lief zweimal: Ein Feld hielt 1.151 Fragen aus der Hauptkennzahl heraus. Wie ich die Daten reparierte, das Modell als unverändert nachwies und beide Läufe veröffentlichte.
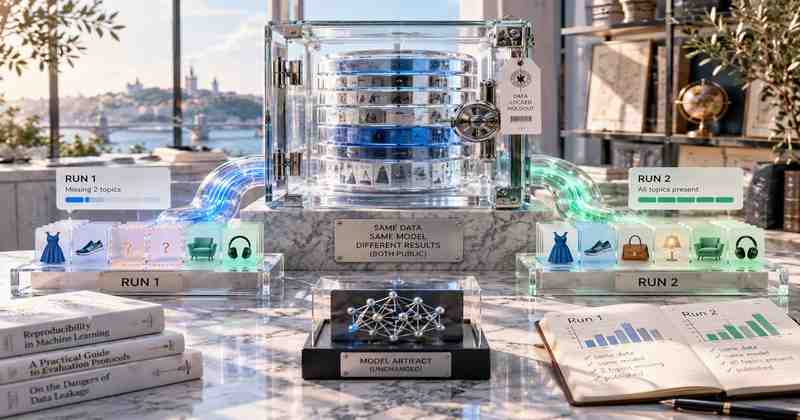
Für ContextLens hatte ich eine Evaluation gebaut, die genau ein einziges Mal laufen durfte. Auf Wikipedia passte ihr erster Lauf zu dem, was ich aus der Entwicklung kannte. Die Stack-Exchange-Hauptkennzahl dagegen war auf eine Weise falsch, auf die ein Modell gar nicht falsch sein kann: Sie beruhte auf 472 Fragen, und keine einzige stammte von einer Technology- oder Science-Site – obwohl vier der elf Sites hinter dieser Zahl von KI, Software-Engineering, Quantencomputing und Wissenschaftsgeschichte handeln.
Das Modell hatte nicht etwa zwei seiner acht Themen vergessen. Eine Sicht auf das Testset hatte sie verloren.
ContextLens ist ein lokaler Themenanalysator für Gespräche: Jede englische Nachricht bekommt eines von 8 Oberthemen und ein primäres Unterthema aus 28 – oder uncertain, wenn sie themenfremd ist. In diesem Beitrag geht es um sein finales Testset – das eine, auf das du nur ein einziges Mal schauen darfst – und darum, was ich tat, als es kaputt zurückkam: Ich habe die Daten offline repariert, nachgewiesen, dass sich das Modell nicht bewegt hatte, neu eingefroren, die Evaluation mit schriftlich festgehaltenem Grund ein zweites Mal laufen lassen und den kaputten Lauf neben dem guten veröffentlicht.
Version 1.0 hatte Test-Splits. Ein Audit von v1.0 benannte das Problem in vier Wörtern: no untouched final holdout – kein unberührtes finales Holdout. Diese Splits waren während der Entwicklung berechnet worden und standen schon in Benchmark-Tabellen, als noch Entscheidungen fielen. Eine Zahl, auf die du beim Auswählen schon geschaut hast, ist nicht mehr blind.
Für v1.1 habe ich deshalb Daten gebaut, die kein Entwicklungsskript liest, und sie committet, bevor das v1.1-Modell ausgewählt und trainiert wurde:
- 374 Wikipedia-Passagen aus Artikeln, die in keiner Version des Korpus vorkommen. Der Builder geht dafür jede committete Version des Label-Manifests in der Git-Historie durch, nicht nur die aktuelle.
- 2.713 Stack-Exchange-Fragen, erstellt zwischen dem 1. Januar und dem 20. September 2026. Die v1.0-Sets bestanden aus MTEB-Clustering-Titeln und den am höchsten bewerteten API-Fragen aller Zeiten; ein Zeitfenster im Jahr 2026 liefert daher überwiegend neue Fragen, und jede Frage, die schon in einem Evaluationsset stand, wurde aussortiert.
- 4.350 CLINC150-Testäußerungen für themenfremden Chat, ohne CLINCs eigene
oos-Klasse und ohne fünf Intents, die durchaus zum Thema passen könnten, dazu die gesperrte Hälfte eines Tatoeba-Sets für das Sprachgate.
Ein Manifest hält Zeilenzahl und SHA-256 der beiden gebauten Dateien fest, dazu einen Hash der gesperrten Hälften von CLINC150 und Tatoeba. Dann kommt die Sperre. scripts/freeze.py bricht ab, wenn getrackte Dateien uncommittete Änderungen haben, und schreibt reports/locked/FREEZE.json: den Commit, die Laufzeiteinstellungen und die SHA-256-Hashes von sechs Dateien – Modellkonfiguration, Taxonomie, Laufzeitkonfiguration, Trainingspassagen, das gesperrte Manifest und die metadata.json des Artefakts, die ihrerseits eine Prüfsumme für jede Modelldatei enthält, bis hinunter zu jeder einzelnen Gewichtsdatei des Encoders. Ein einziger Hash steht so für das gesamte trainierte Modell. evaluate.py --stage locked prüft all das, bevor es das Modell lädt:
def check_freeze(model_dir: Path, rerun_reason: str | None) -> dict:
    freeze_path = LOCKED_DIR / "FREEZE.json"
    if not freeze_path.exists():
        raise SystemExit("no reports/locked/FREEZE.json - run scripts/freeze.py before the locked evaluation")
    freeze = json.loads(freeze_path.read_text(encoding="utf-8"))
    now = freeze_fingerprint(model_dir)
    changed = [k for k, v in freeze["files"].items() if now.get(k) != v]
    if changed:
        raise SystemExit(f"configuration changed since the freeze: {changed}")
    results = LOCKED_DIR / "results.json"
    if results.exists() and not rerun_reason:
        raise SystemExit("the locked holdout was already evaluated; pass --rerun-reason to record a second run")
    return freeze
Dreimal Nein: keine Freeze-Datei, ein geänderter Fingerabdruck, ein zweiter Lauf ohne Grund. Das dritte Nein wirkt wie eine Formalität. Dieser ganze Beitrag handelt von genau der Situation, für die diese Zeile geschrieben wurde – und am Ende schlug sie kein einziges Mal an.
Die Stack-Exchange-Fragen dienen zwei Evaluationen, und genau dort steckte der Bug.
Die Oberthemen-Sicht fragt, ob das Modell das Oberthema richtig trifft. Die Fragen stammen von elf Sites, und jede erhält das Label ihrer Site: physics und astronomy sind Physics; ai, softwareengineering und quantumcomputing sind Technology; hsm (Wissenschafts- und Mathematikgeschichte) ist Science.
Die Unterthemen-Sicht fragt dasselbe für das Unterthema. Ihre Fragen kommen aus Abfragen nach Site und Tag – physics mit dem Tag quantum-mechanics ergibt Quantum Mechanics –, und vier Unterthemen entsprechen einer kompletten Site, ohne jeden Tag: KI (ai), Software (softwareengineering), Quantencomputing (quantumcomputing) und Wissenschaftsgeschichte (hsm).
Eine Frage kann in der Oberthemen-Sicht liegen, in der Unterthemen-Sicht, in beiden oder in keiner. Das sind zwei voneinander unabhängige Tatsachen. Das Build-Skript speicherte sie als einen einzigen Wert:
# scripts/build_locked_sets.py as it was for run 1 (removed in commit 9613200)
# runs for every (site, tag) query of every subtopic; g is its general topic
row = rows.setdefault(
    key, {**q, "set": "subtopic", "general": g.id, "subtopics": [], "is_ood": False}
)
row["set"] = "subtopic" if row["set"] == "subtopic" or row["general"] == g.id else row["set"]
Zuerst wurden die Sites der Oberthemen-Sicht abgerufen und ihre Fragen als general markiert; danach kamen die Unterthemen-Abfragen. Eine Frage, die erst dort auftauchte, wurde als subtopic markiert, und eine, die schon als general gespeichert war, wurde auf subtopic umgestellt, sobald die Themen übereinstimmten. So oder so landete eine Frage von einer der elf Sites außerhalb der Oberthemen-Sicht, obwohl ihre Site sagte, dass sie dorthin gehörte.
Bei den sechs Klassen, die überhaupt Fragen behielten, kostete das zwischen 31 und 75 Prozent davon; bei Physics blieben 164 von 653 übrig. Bei den vier Unterthemen, die eine ganze Site umfassen, kostete es jede einzelne Frage, denn dort war die Unterthemen-Abfrage die Site-Abfrage – dieselbe Site, dasselbe Zeitfenster, dieselbe Sortierung, kein Tag. Sie lieferte genau das, was die Oberthemen-Abfrage schon gespeichert hatte, und alles wurde umgestellt: In der gesperrten Datei von Lauf 1 tragen alle 399 Fragen von ai, softwareengineering, quantumcomputing und hsm den Eintrag "set": "subtopic". Aus diesen vier Sites bestehen Technology und Science in der Oberthemen-Sicht vollständig – deshalb fielen genau diese beiden Klassen auf null.
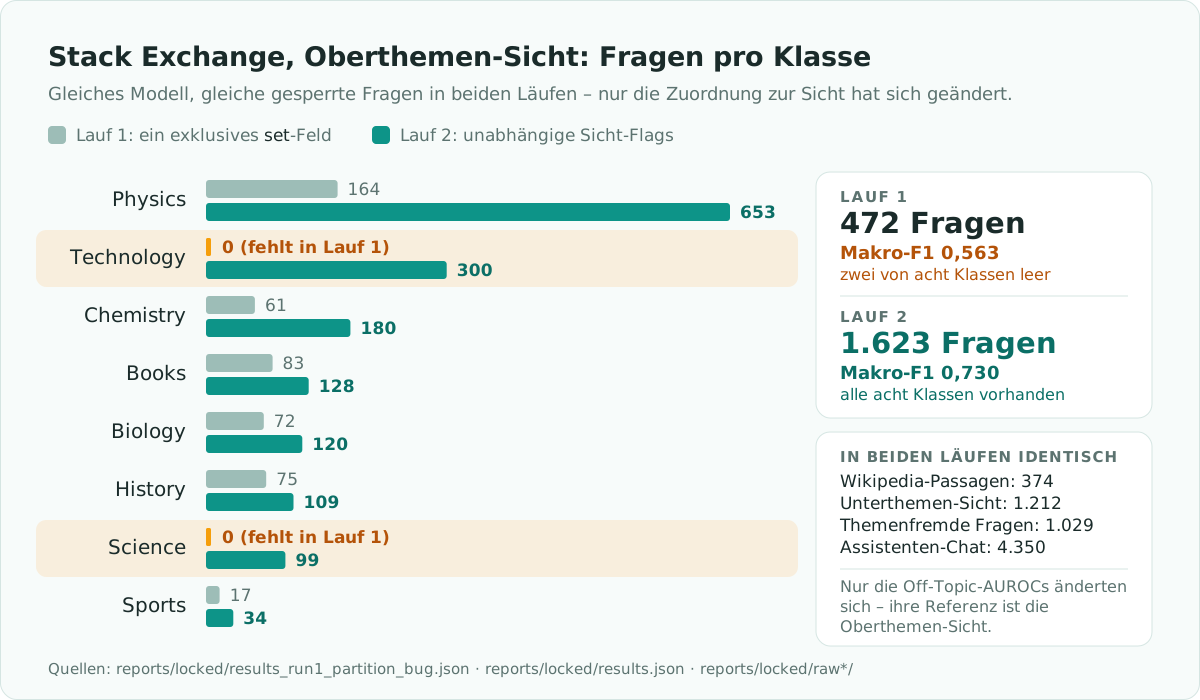
Bewertet hat Lauf 1 diese Fragen durchaus, nur eben in der anderen Sicht: Derselbe Lauf kam mit demselben Modell in der Unterthemen-Sicht bei 317 Technology-Fragen auf einen F1-Wert von 0,862.
Nichts stürzte ab, und die Hauptkennzahl war nicht absurd: Accuracy 0,735, Makro-F1 0,563. Das liest sich wie ein schwaches Modell. In Wahrheit war es ein Mittelwert über zwei leere Klassen: Über die sechs Klassen mit Fragen lag der Makro-F1 bei 0,751, und Technology und Science gingen als Nullen in den Mittelwert ein.
Verräterisch war die Form der Daten: 472 Fragen und zwei Klassen ohne jeden Support, während das Entwicklungsset mit echten Fragen (ext_dev) 1.500 Technology- und 951 Science-Fragen enthält. Und der Schaden zog Kreise. Beide Off-Topic-AUROCs nutzen die Oberthemen-Sicht als In-Domain-Referenz, also bewegten sich beide: 0,942 → 0,961 beim Assistenten-Chat, 0,838 → 0,886 bei Fragen von themenfremden Stack-Exchange-Sites. Eine kaputte Sicht, und jede Zahl, die darauf aufbaute, war falsch.
Für die Reparatur galt eine einzige Bedingung: keine Frage, keine Label-Regel und nichts am Modell ändern – nur die Zuordnung der Fragen zu den Sichten. Eine neue Definition brauchte es auch nicht: Wiederhergestellt wurde nur die Regel, die das Oberthemen-Set von v1.0 schon immer verwendet hatte – eine Frage liegt in der Oberthemen-Sicht, wenn ihre Site dazugehört, und die Site liefert das Label. Die Unterthemen-Sicht hatte das Feld set nie gelesen – sie umfasste schon immer jede Frage innerhalb der Taxonomie, die ein Unterthema hat –, also brauchte nur die Oberthemen-Sicht ein eigenes Flag:
for r in rows:
    r.pop("set", None)
    r["in_general"] = r["site"] in site_general or r["site"] in ood_sites
    r["site_general"] = site_general.get(r["site"])
Die Fragen themenfremder Sites landen ohne Label in der Oberthemen-Sicht, als Negativbeispiele für die Off-Topic-Evaluation. Ein neuer --repair-Modus leitet die Flags aus der gespeicherten se_locked.jsonl neu ab, ohne eine einzige Netzwerkanfrage – so konnte keine Frage neu abgerufen, hinzugefügt oder verloren werden. Auf der Evaluationsseite änderte sich eine Zeile: Die Oberthemen-Sicht umfasst seitdem jede Frage mit in_general, gelabelt nach ihrer Site.
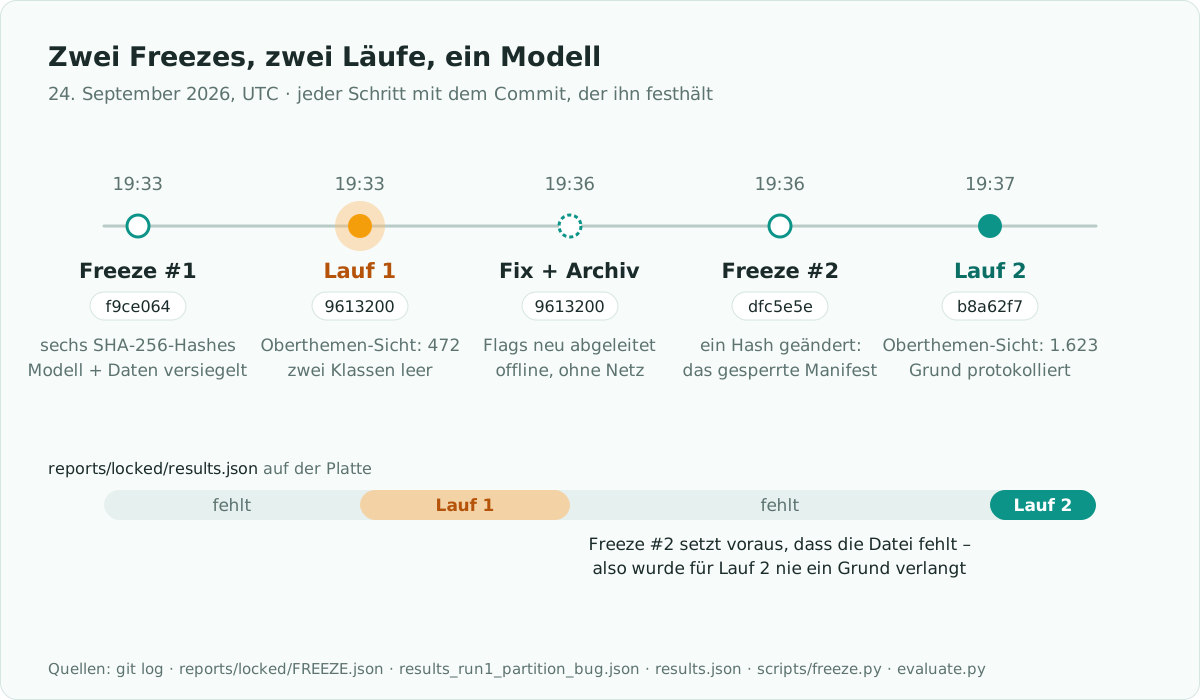
Lauf 1 verschwand nicht. Seine Ergebnisse wurden als reports/locked/results_run1_partition_bug.json committet, zusammen mit seinen Rohvorhersagen und seinen _run1-Abbildungen, und D-36 im Entscheidungslog erklärt, was passiert ist. Dann habe ich neu eingefroren. Das hier ist der gesamte Unterschied zwischen den beiden Freezes – unveränderte Zeilen gekürzt, Hashes auf zwölf Zeichen gekappt:
# git show dfc5e5e -- reports/locked/FREEZE.json
-  "frozen_at": "2026-09-24T19:33:30+00:00",
-  "commit": "f0f1b0638887…",
+  "frozen_at": "2026-09-24T19:36:51+00:00",
+  "commit": "96132001674c…",
-    "data/locked/MANIFEST.json": "78f3cb1b90ec…",
+    "data/locked/MANIFEST.json": "30a2f6d55aac…",
     "models/contextlens-topic/metadata.json": "daf72ce77472…"
Commit und Zeitstempel sind neu; der Hash des Manifests ist ein anderer, weil sich die Sicht-Flags in der gesperrten Datei geändert haben. Der Hash der Metadaten blieb gleich – und dieser Hash ist das Modell.
Lauf 2 bestand dieselbe Fingerabdruckprüfung, und seine Ergebnisdatei sagt, warum es überhaupt einen Lauf 2 gibt: „run 2 after fixing the locked Stack Exchange view partition bug (D-36); model and configuration unchanged“.
Der stärkste Beleg steckt in den Rohvorhersagen. Die Wikipedia-Datei und beide Off-Topic-Dateien sind in beiden Läufen byte-identisch. Alle 472 Fragen, die Lauf 1 in der Oberthemen-Sicht bewertet hat, tauchen in Lauf 2 mit demselben vorhergesagten Label, derselben Konfidenz und demselben uncertain-Flag wieder auf; nur der Off-Topic-Score von 100 davon verschiebt sich um höchstens zwei Millionstel seines Werts – das Gleitkomma-Rauschen, das entsteht, wenn dieselben Texte in anderen Batches eingebettet werden. Lauf 2 hat das Modell nicht anders bewertet. Er hat 1.151 Fragen mehr bewertet: die, die Lauf 1 aus der Oberthemen-Sicht herausgelassen hatte.
Nichts hat mich gezwungen, Lauf 1 zu veröffentlichen. Es war ein Datenbug, das Modell hat sich nie geändert, und mit einer gelöschten Datei wäre die Geschichte aufgeräumter gewesen. Er blieb aus drei Gründen.
Er macht die Behauptung überprüfbar. „Das Modell hat sich zwischen den Läufen nicht geändert“ ist genau der Satz, bei dem aufmerksame Leser misstrauisch werden sollten – denn genau das würde auch jemand schreiben, der still und leise so lange neu gerechnet hat, bis die Zahl besser aussah. Mit beiden Läufen im Repo muss mir niemand aufs Wort glauben.
Er dokumentiert den Bug besser als jede Prosa. Die 472 Fragen und zwei leeren Klassen von Lauf 1 neben den 1.623 Fragen und allen acht Klassen von Lauf 2 zeigen in einer einzigen Tabelle, was ein exklusives Feld mit einem Datensatz anrichtet.
Die Guards hätten mich nicht aufhalten können. freeze.py weigert sich, einen neuen Freeze zu schreiben, solange reports/locked/results.json existiert, und die Meldung sagt auch, warum: „a new freeze would hide that“ – ein neuer Freeze würde das verdecken. Um neu einzufrieren, musste ich die Ergebnisse von Lauf 1 beiseiteräumen; sie landeten unter ihrem neuen Namen im selben Commit, der auch den Builder repariert hat. Damit war zugleich der Rerun-Guard entschärft: Ohne results.json auf der Platte fragt evaluate.py nach keinem Grund. Ich habe --rerun-reason trotzdem übergeben. Die Guards verhindern ein Versehen; eine Entscheidung verhindern sie nicht. Legitim macht Lauf 2 erst die Aktenlage: Das Archiv ist ein Commit, der Grund steht im JSON, das Entscheidungslog hat D-36, und KNOWN_ISSUES.md listet „Locked evaluation was run twice“ als Punkt 12, Schweregrad niedrig, offengelegt.
Streng ist das Siegel auch im Kleinen. Nach dem gesperrten Lauf habe ich das GitHub-Repository noch einmal umbenannt, in ContexLens, aber die Websuche schickt im User-Agent weiterhin den Zwischennamen ContexLens-NLP (GitHub leitet alte Namen weiter). Der String steht in contextlens/config.py, einer Datei mit Fingerabdruck, und eine kosmetische URL ist es nicht wert, einen Freeze zu brechen.
Ein Holdout, das du still und leise neu laufen lassen kannst, ist bloß ein Validierungsset mit besseren Manieren.
Ein versiegeltes Testset beglaubigt die Entscheidungen, die vor dem Versiegeln gefallen sind. Triffst du sie auf den falschen Daten, beglaubigt die Sperre die falsche Antwort, ohne mit der Wimper zu zucken.
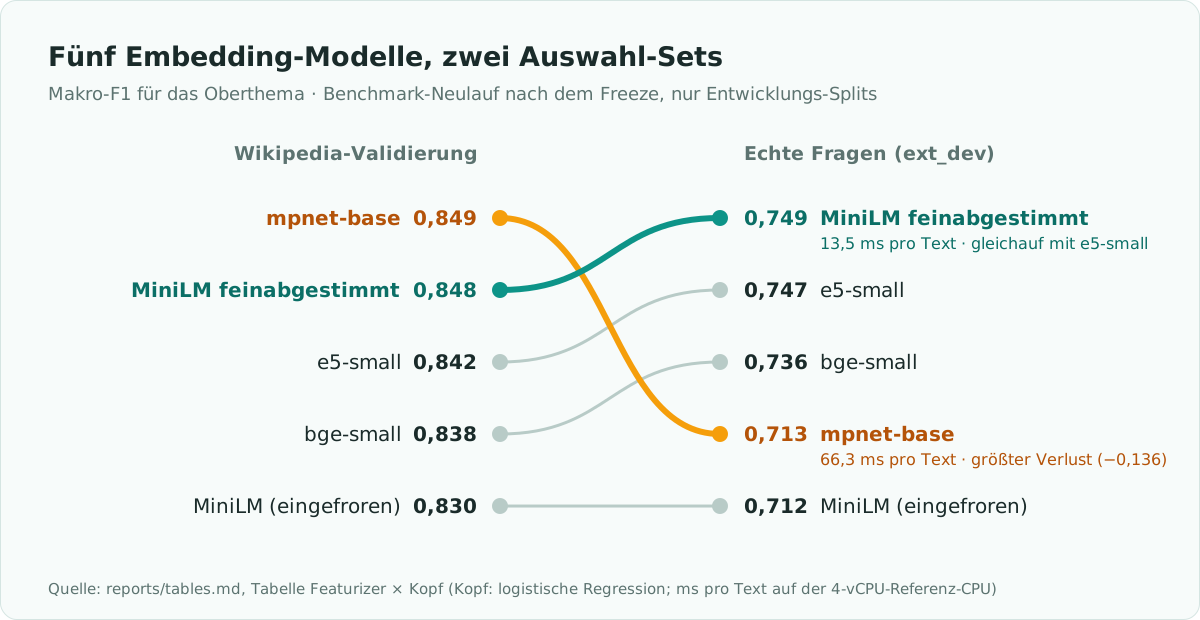
ContextLens stimmt Hyperparameter auf der Wikipedia-Validierung ab, wählt Modellfamilien aber auf der Validierung und auf echten Stack-Exchange-Fragen (ext_dev) aus – denn Nutzer tippen kurze Fragen, keine Lexikonabsätze. In diesem Projekt musste das zweite Set das erste nie überstimmen: Als ich den Encoder ausgewählt habe, noch auf den v1.0-Labels, lag der feinabgestimmte MiniLM auf beiden vorn. Der Benchmark-Neulauf auf dem finalen Korpus – nach dem Freeze, nur auf Entwicklungs-Splits – zeigt, wogegen das zweite Set absichert:
| Oberthema, Makro-F1 | Wikipedia-Validierung | echte Fragen | ms / Text | MB |
|---|---|---|---|---|
| mpnet-base (eingefroren) + LR | 0,849 | 0,713 | 66,3 | 437,9 |
| e5-small (eingefroren) + LR | 0,842 | 0,747 | 25,3¹ | 133,4 |
| MiniLM feinabgestimmt + LR | 0,848 | 0,749 | 13,5 | 90,9 |
¹ Auf einer unbelasteten Maschine nachgemessen; der Benchmark-Lauf hatte e5-small unter Last erwischt.
Auf Wikipedia liegen die beiden Ersten gleichauf, und ein Gleichstand kann nicht entscheiden: Das Argmax nimmt mpnet-base – ein Modell, das etwa fünfmal langsamer und größer ist. Auf echten Fragen löst sich der Gleichstand auf, und das nicht nur wegen des Fine-Tunings – schon unter den eingefrorenen Encodern allein fällt mpnet-base von Platz eins auf Wikipedia hinter e5-small und bge-small zurück, Modelle mit rund einem Drittel seiner Größe. Besser kalibriert als der feinabgestimmte MiniLM ist mpnet-base auf beiden Sets zwar, aber Kalibrierung ist im Protokoll das letzte Kriterium bei Gleichstand, nach Latenz und Größe – und die sprechen beide für den MiniLM. Der Modellbericht bringt es auf einen Satz: choosing on Wikipedia alone would pick the wrong, slowest model – wer nur auf Wikipedia auswählt, landet beim falschen und obendrein langsamsten Modell.
Das sind die Zahlen von Lauf 2, also die, die das Projekt berichtet:
| gesperrtes Set | n | Accuracy | Makro-F1 | ECE |
|---|---|---|---|---|
| Wikipedia, ungesehene Artikel | 374 | 0,8476 | 0,8382 | 0,0579 |
| Stack-Exchange-Fragen, 2026 | 1.623 | 0,8035 | 0,7304 | 0,0560 |
| dasselbe, ohne die Site zur Wissenschaftsgeschichte | 1.524 | 0,8432 | 0,8178 (7 Klassen) | – |
Das Off-Topic-Gate antwortet bei 78,1 % des CLINC150-Assistenten-Chats mit uncertain (AUROC 0,961), bei Fragen von themenfremden Stack-Exchange-Sites aber nur bei 48,5 % (AUROC 0,886), und eine Nachricht braucht im Median 19,9 ms auf einer Maschine mit 4 vCPUs.
Die Schwachstelle liegt offen zutage: Science kommt auf echten Fragen in der Oberthemen-Sicht auf einen F1-Wert von 0,241. Alle 99 Science-Fragen in dieser Sicht stammen von hsm, und 42,4 % davon werden als Physics vorhergesagt – „Why Euler didn't include viscosity in equations of fluid dynamics?“ landet mit einer Konfidenz von 0,963 bei Physics. Seit Version 1.2.0 der Taxonomie steht Science für den Wissenschaftsbetrieb selbst – Methode, Forschungspraxis, die Wissenschaftsgeschichte als solche –, deshalb lässt sich diese Frage durchaus als Physics lesen, und hsm wird separat ausgewiesen, statt stillschweigend gestrichen zu werden. Die projekteigene Regel misst Science auf den Fragen der Unterthemen-Sicht, wo die Klasse auf 143 Fragen 0,420 erreicht. Was ich nicht getan habe, ist genau das, was die Sperre verhindern soll: 0,241 sehen, zurückgehen und die Zahl hochtunen. Ein zweites Oberthema für Fragen zur Geschichte eines Fachs („Physics + history“) steht im Backlog, ausdrücklich nicht für v1 geplant.
- Den Schlüssel zu dieser Sperre habe ich selbst. Der Fingerabdruck beweist, dass sich die Dateien zwischen Freeze und Lauf nicht geändert haben – nicht, dass ich die gesperrten Dateien nie auf anderem Weg geöffnet habe. Dahinter steht die öffentliche Commit-Historie, und Historie ist ein Indiz, kein Beweis: Die Historie dieses Repositorys wurde vor v1.1 einmal umgeschrieben, um ein überholtes Modellartefakt zu entfernen, und ein Commit hält das fest.
- Nichts prüft das von selbst nach. Der CI-Workflow lässt sich nur manuell auslösen, seine Schritte laufen lokal über
scripts/ci.sh, und kein Test vergleicht die committeten Dateien mitFREEZE.json. - Die Sets sind klein. Bei 29 bis 60 Wikipedia-Passagen pro Oberthema sind die Werte einzelner Klassen mit großer Unsicherheit behaftet, und drei Unterthemen – Periodensystem, Quantencomputing, wissenschaftliche Methode – haben überhaupt keine gesperrte Wikipedia-Passage.
- Die Haupttabelle erwähnt Lauf 1 nicht. In der README-Tabelle mit den gesperrten Ergebnissen steht „evaluated once after the freeze“. Wer D-36 oder die Liste bekannter Probleme nie öffnet, sieht Lauf 1 nicht – dabei gehört die Offenlegung direkt neben die Zahl.
- Für diesen Beitrag wurde nichts neu gerechnet. Jede Zahl hier stammt aus committeten Dateien. Beim Schreiben habe ich nur dreierlei berechnet: einen byteweisen Vergleich der unveränderten Vorhersagedateien, einen zeilenweisen Abgleich der 472 Fragen und Zählungen über die committeten Dateien.
- Baue und committe das gesperrte Set, bevor die Entscheidungen fallen, über die es urteilen soll.
- Sichere per Fingerabdruck alles, was das System definiert – inklusive der Prüfsummen des Modells selbst –, und verweigere bei jeder Abweichung den Lauf.
- Speichere Gruppenzugehörigkeit als unabhängige Flags und prüfe den Support pro Klasse, bevor du auch nur einen einzigen Score berechnest.
- Wenn du doch ein zweites Mal auswerten musst: offline reparieren, neu einfrieren, den kaputten Lauf archivieren und den Grund in die Ergebnisse schreiben – auch wenn das Tooling nicht danach fragt.
- Setz die Offenlegung in die Tabelle, die zitiert wird, direkt neben die Zahl.
Das Entscheidungslog, beide Ergebnisdateien und die Rohvorhersagen beider Läufe liegen unter Apache-2.0 im ContexLens-Repository.
Ein gesperrtes Holdout ist kein Versprechen, es nie zweimal laufen zu lassen. Es ist das Versprechen: Wenn du es doch tust, kann jeder sehen, warum. Brich das Siegel, wenn die Daten falsch sind – nie, weil dir die Zahl falsch vorkommt. Und lass den kaputten Lauf dort liegen, wo ihn jeder lesen kann.