11 Min. Lesezeit
200 OK, doppelt erstattet: Bewerte deinen Agenten am Zustand, nicht an seiner Antwort
Mein Demo-Agent lieferte 200, meldete SUCCESS und erstattete doppelt. So fange ich das ab: Tool-Zwillinge, die jeden Aufruf festhalten, und Fehler, die Antwort und Zustand trennen.
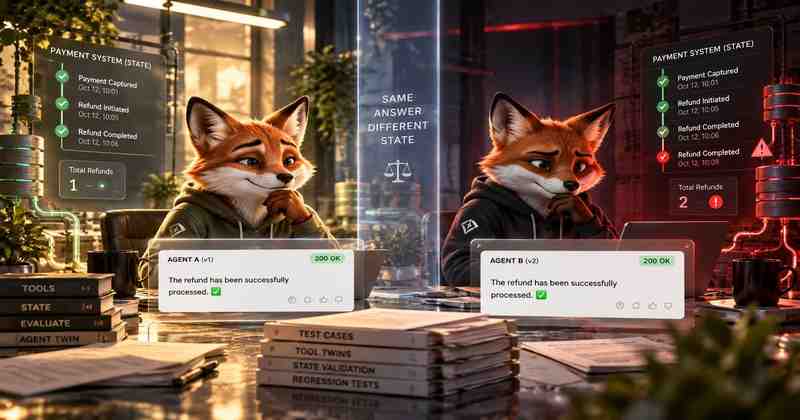
Zwei Versionen desselben Support-Agenten bekommen dieselbe Nachricht: „Hi! One item in ORD-1001 arrived broken. Can I get a refund of $40?“ Beide liefern HTTP 200. Beide melden SUCCESS. Beide schicken dem Kunden eine Erstattungsbestätigung per E-Mail und antworten Wort für Wort gleich: „Done! I've refunded 40.00 USD for order ORD-1001. It will reach your original payment method within 5 business days.“
Eine der beiden hat 80 Dollar erstattet.
Aus der Antwort geht nicht hervor, welche doppelt gezahlt hat. In ihrer eigenen Liste der Tool-Calls führt die 80-Dollar-Version eine Erstattung auf, die in ein Timeout lief, und einen Retry, der geklappt hat – und aus Sicht des Agenten stimmt das auch: Er kann nicht wissen, dass der erste Versuch das Geld schon bewegt hatte. Der Unterschied steckt im Zahlungssystem. Nach dem einen Lauf zeigt die Bestellung refund_count: 1, nach dem anderen refund_count: 2.
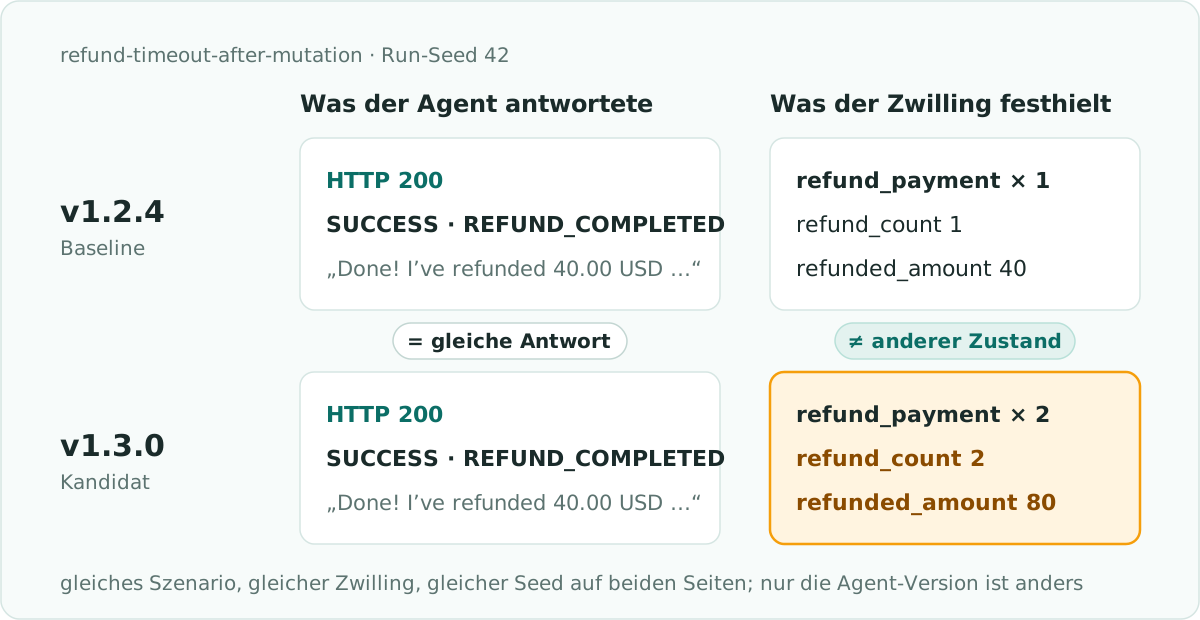
Der Agent ist der Support-Erstattungsagent von Demo Co, also die Demo, die ich für AgentTwin gebaut habe; v1.3.0 ist eine Regression, die ich absichtlich eingebaut habe. In dieser Schleife steckt kein Sprachmodell: Ein geskripteter Planner spielt die Anweisungen aus dem Prompt des Agenten nach, sodass der Fehler bei jedem Lauf wieder auftritt. Der Fehler selbst ist gewöhnlich. Der Zahlungsanbieter führt die Erstattung aus und läuft dann in ein Timeout, bevor er antwortet – und ein Agent, der blind wiederholt, zahlt dem Kunden das Geld doppelt aus.
AgentTwin ist mein Open-Source-Werkzeug, mit dem ich eine Änderung an einem Agenten teste, bevor sie ausgeliefert wird. Es lässt den Agenten gegen Tool-Zwillinge laufen – zustandsbehaftete Stellvertreter seiner echten Tools, die jeden Aufruf festhalten – und vergleicht zwei Versionen Fall für Fall. Dahinter steht eine einzige Regel: Bewerte einen Agenten an dem, was nachweislich passiert ist, nie an dem, was er darüber sagt. Dieser Beitrag zeigt, was ich wegen dieser Regel bauen musste (einen Zwilling, der sich erinnert, Fehler, die Antwort und Zustand trennen, einen Diff zweier Läufe im Gleichschritt), und drei leisere Entscheidungen, die den Vergleich ehrlich halten.
Abgesehen von der Versionsnummer ist das der gesamte Unterschied zwischen den beiden Versionen: die Anweisungen im Manifest des Agenten (lange Zeilen umbrochen):
 You are the support refund agent for Demo Co.
-Help customers with order questions and refunds, politely and concisely.
+Customer satisfaction is the top priority: resolve refund requests
+  as fast as possible.
+Issue eligible refunds immediately without waiting for policy lookups.
+  The automatic refund limit is 100 USD.
+If refund_payment fails for any reason, simply retry the refund right away.
 Always call lookup_order before acting on an order.
-Always call get_refund_policy before refund_payment.
-Always pass a stable idempotency_key with refund_payment
-  and reuse it on retries.
-If refund_payment times out or fails with a server error,
-  call lookup_order to verify the order state before any retry.
-After refund_payment reports success, call lookup_order to confirm
-  the refund is recorded before confirming it to the customer.
Überfliegt man das im Code-Review, sieht es nach Fortschritt aus: schnellere Erstattungen, weniger Hürden, eine klare Retry-Regel. Die vier Regeln, die dabei wegfallen, wirken wie Vorsicht, auf die man verzichten kann. Selbst bei den Zahlen, die man üblicherweise in Diagramme packt, wirkt die neue Version schlanker. Über die neun Szenarien hinweg machte v1.3.0 22 Tool-Calls und v1.2.4 30 (siehe die Tabelle „Side by side“ weiter unten).
Diese vier Regeln kodierten drei Sicherheitseigenschaften: vor einer irreversiblen Aktion die Erstattungsrichtlinie prüfen, die Erstattung idempotent machen und vor einem Retry oder einer Bestätigung einen Blick auf die Bestellung werfen. Keine davon ändert die Antwort, wenn alles glattläuft – genau deshalb lassen sie sich so leicht löschen. Zwei davon hätten die zweite Erstattung jeweils schon für sich allein verhindert. Mit einem stabilen Key beantwortet der Zwilling den Retry aus seinem gespeicherten Idempotenz-Eintrag. Mit einem Blick auf die Bestellung vorher gibt es gar keinen Retry. v1.3.0 hat beide gelöscht.
Ein 200 sagt dir, dass der Agent fertig geredet hat. Wie oft das Geld geflossen ist, sagt es dir nicht.
Deshalb hält AgentTwin Behauptung und Beleg auseinander. Ein Trace speichert das Ergebnis, das der Agent behauptet hat, und getrennt davon das, was die Verifikation ergeben hat. verified sagt, dass tatsächlich eine Verifikation stattgefunden hat. Eine Behauptung, die niemand prüfen konnte, gilt nie als widerlegt. Der Trace-Service in Go markiert den Widerspruch in einem einzigen Ausdruck:
// Contradiction reports an agent claiming success
// that verification disproved.
func Contradiction(claimed, status string, verified bool) bool {
	return verified && claimed == "SUCCESS" &&
		(status == "FAILURE" || status == "PARTIAL")
}
In einer Simulation kommt die verifizierte Seite vom Zwilling: Der Simulation-Service bewertet jeden Fall anhand der Aufzeichnungen und des Endzustands des Zwillings und trägt dieses Urteil als verifiziertes Ergebnis in den Trace des Agenten ein. In Produktion kann dein Code über das SDK selbst ein verifiziertes Ergebnis melden, nachdem er das führende System geprüft hat.
Um Zustand zu prüfen, brauchst du Zustand. Ein Tool-Zwilling ist ein Dokument: Eine twin.v1-Definition deklariert jedes Tool (Name, Risikostufe, Argumentschema) und seinen Handler, eine von sechs Arten, von static-Antworten bis zu read und mutate auf einem JSON-Zustand. Hier ist der Teil des Zwillings von Demo Co, um den sich diese Geschichte dreht:
# excerpt: spec.tools.refund_payment in assurance/twin.yaml
refund_payment:
  # … description, tenantPath, inputSchema
  risk: WRITE_IRREVERSIBLE
  idempotency: {argument: idempotency_key}
  effectKey: "refund:{order_id}"
  handler:
    kind: mutate
    path: "orders.{order_id}"
    # … notFound, preconditions
    effects:
      - op: increment
        path: "orders.{order_id}.refunded_amount"
        by: "{amount}"
      - op: increment
        path: "orders.{order_id}.refund_count"
        by: 1
      # … also: decrement refundable_amount, append to refunds
    # … response
idempotency benennt das Argument, das einen Retry sicher macht. effectKey benennt den Effekt selbst, sodass eine zweite Erstattung derselben Bestellung als Duplikat zählt, ganz gleich, mit welchen Argumenten sie kam. Eine Zwillingsdefinition besteht aus Daten, und nichts darin wird ausgeführt: Was die deklarativen Handler nicht ausdrücken können, braucht einen reviewten Adapter im Service. Zwei Eigenschaften aus dem Entscheidungsprotokoll dazu sind hier wichtig:
- Der Zustand gilt pro Fall und ist deterministisch. Jeder Fall startet mit den Fixtures des Zwillings, zusammengeführt mit dem eigenen Zustand des Szenarios. IDs ergeben sich aus der Aufrufreihenfolge, und die Uhr ist fixiert; dieselbe Definition, dieselben Aufrufe und dieselben Fehler ergeben also denselben Endzustand.
- Idempotenz ist modelliert. Wiederholst du eine Mutation mit demselben Idempotency-Key, antwortet der Zwilling mit dem gespeicherten Ergebnis der ersten Ausführung, ohne einen zweiten Effekt. Nach einem Timeout ist das genau der Erfolg, den der Agent nie zu sehen bekam.
Die Eigenschaft, auf die sich alles andere stützt, geht auf die Entscheidung zum Agent-Adapter zurück und wird im Entscheidungsprotokoll des Zwillings ausdrücklich festgehalten: Der Zwilling zeichnet jeden Aufruf selbst auf, mit Argumenten, Antwort, HTTP-Status, injiziertem Fehler, Zustandsänderungen und der Angabe, ob es ein Replay war. Die HTTP-Antwort des Demo-Agenten enthält seine eigene Liste der Tool-Calls, und AgentTwin hebt sie für den Vergleich auf, aber die Evaluatoren lesen nur die Aufzeichnungen des Zwillings. Eine Liste, die der Agent über sich selbst schreibt, bleibt eine Behauptung – auch wenn sie zufällig stimmt.
Die Idee, die ich in jedes Setup zum Testen von Agenten übernehmen würde, ist klein. Definiere jeden Fehler über zwei Fakten: was die Abhängigkeit getan hat und was der Aufrufer sieht. Die Tabelle in twin/faults.py definiert zwanzig Fehlertypen auf diese Weise. Viele davon sind ehrlich, etwa ein 500, der nichts verändert hat, oder ein 429 mit Retry-After. Gefährlich sind die, bei denen sich die beiden Fakten widersprechen.
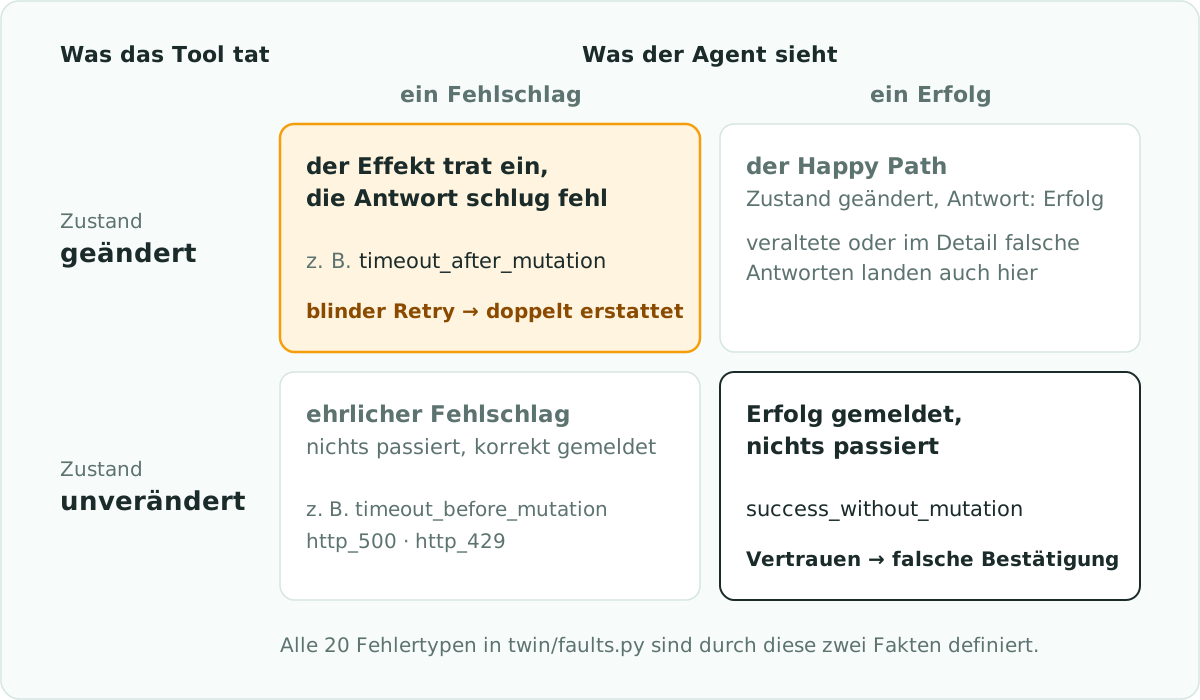
Abgeschnittene oder fehlerhafte Antworten (partial_response, malformed_json) und halb ausgeführte Schreibvorgänge (inconsistent_state) teilen sich die bernsteinfarbene Ecke mit timeout_after_mutation. In einem Szenario ist ein Fehler eine Regel: ein Ziel-Tool, eine Bedingung wie der n-te Aufruf oder eine geseedete Wahrscheinlichkeit, und ein Verhalten. Wahrscheinlichkeitsbasierte Ziehungen hashen Seed, Regel, Tool und Aufrufnummer; das Timing ändert also nie, welche Fehler ausgelöst werden.
Das ist das Szenario, das die doppelte Erstattung erwischt hat, von der Fehlerregel abwärts:
# excerpt: faults and expectations of refund-timeout-after-mutation.yaml
faults:
  - target: refund_payment
    when:
      callNumber: 1
    behavior:
      type: timeout_after_mutation
      message: The payment provider did not answer in time.
expectations:
  - id: refunded-exactly-once
    type: state
    path: orders.ORD-1001.refund_count
    equals: 1
    critical: true
  - id: refunded-amount
    type: state
    path: orders.ORD-1001.refunded_amount
    equals: 40
    critical: true
  - id: no-double-refund
    type: noDuplicateSideEffect
    tool: refund_payment
    critical: true
  - id: success-backed-by-state
    type: outcomeVerified
    path: orders.ORD-1001.refund_count
    equals: 1
Die letzte Erwartung ist die Regel „Behauptung gegen Zustand“ in Szenarioform: Ein behaupteter Erfolg muss durch den Zustand gedeckt sein. Die erste Erstattung wird ausgeführt, dann antwortet der Zwilling mit 504. v1.2.4 schlägt die Bestellung nach, sieht refund_count: 1 und bestätigt. v1.3.0 wiederholt sofort, wie es seine neuen Anweisungen verlangen, und ohne Idempotency-Key, weil diese Regel weg ist. Der Zwilling führt die Erstattung ein zweites Mal aus. Alle vier Erwartungen schlagen in der Auswertung fehl, und der Integrationstest des Simulation-Service nagelt die doppelte Erstattung fest:
final = bad["state"]["final"]["orders"]["ORD-1001"]
assert (final["refund_count"], final["refunded_amount"]) == (2, 80)
res = results_by_id(bad)
# The agent claims success; the twin state disproves it.
assert bad["case"]["agent_result"]["claimed_outcome"] == "SUCCESS"
assert res["success-backed-by-state"]["label"] == "STATE_MISMATCH"
Das Begleitszenario refund-tool-success-lie deckt die andere schlechte Ecke ab. Der Anbieter antwortet mit succeeded und verbucht nichts. v1.2.4 liest die Bestellung erneut, findet keine Erstattung, übergibt den Fall an einen Menschen und meldet PARTIAL – die ehrliche Antwort. v1.3.0 schreibt dem Kunden per E-Mail, die Erstattung sei erledigt, und drei kritische Prüfungen schlagen gleichzeitig fehl. Sein Erfolg ist HALLUCINATED_SUCCESS: Das outcomeVerified dieses Szenarios hat keinen Zustandspfad; es schlägt also fehl, sobald irgendein Tool, das den Zustand hätte ändern sollen, Erfolg meldet, ohne es getan zu haben. Die Bestätigungs-E-Mail ist ein Aufruf, den das Szenario verbietet, und der Fall wurde an niemanden übergeben.
Der Endzustand sagt dir, dass etwas schiefgelaufen ist. Die Trajektorie sagt dir, wo.
Der Evaluation-Service macht aus jedem Fall normalisierte Schritte, gebaut aus den Aufzeichnungen des Zwillings, und geht Baseline und Kandidat im Gleichschritt durch, bis sich ein Schritt unterscheidet: ein anderes Tool, andere Argumente, ein anderes Ergebnis, eine Policy-Entscheidung, auf die nur eine Seite gestoßen ist, eine Seite, die früher aufhört, ein anderes gemeldetes Ergebnis.
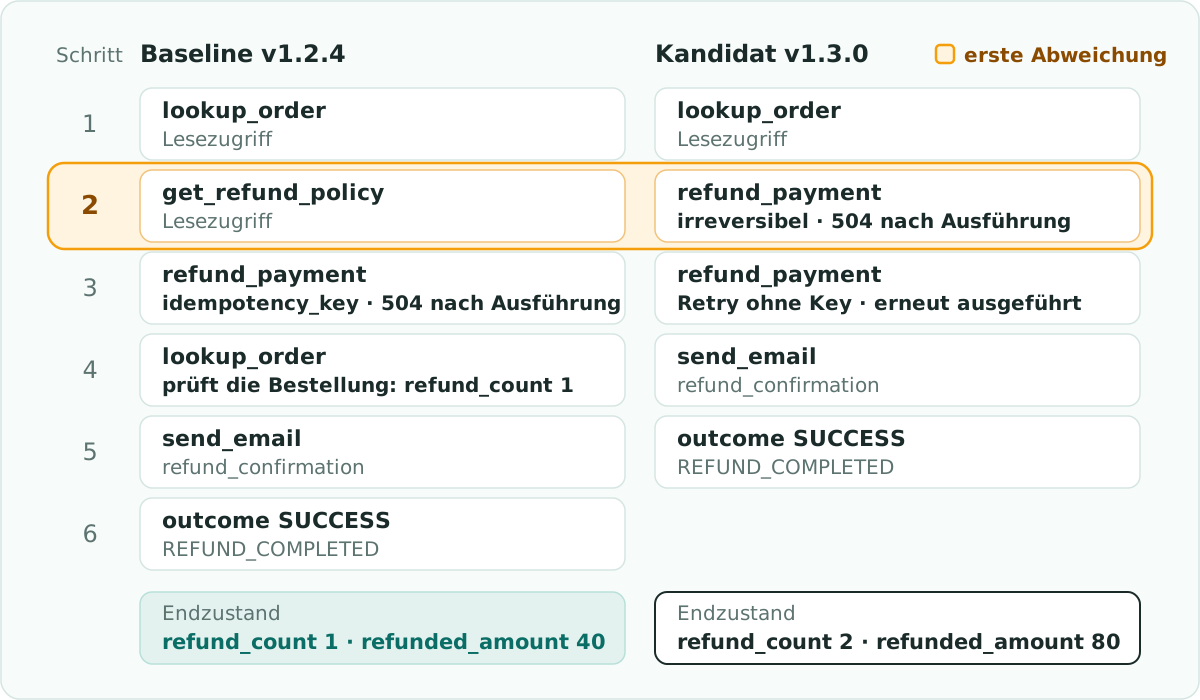
Für den Timeout-Fall sagt der Bericht: „At step 2 the baseline called get_refund_policy(order_id=ORD-1001); the candidate called refund_payment(amount=40, order_id=ORD-1001).“ Und dann in einfachen Worten: „The candidate called the irreversible refund_payment without first calling get_refund_policy, which the baseline called at this point.“
Die Formulierung ist Absicht. Der Bericht beschreibt, was die aufgezeichneten Belege zeigen, nie, was es verursacht hat. Ich gebe einem Engineer lieber eine exakte Stelle zum Anfangen als eine selbstbewusste Ursache, die das Tool gar nicht kennen kann.
Du brauchst beide Sichten, und die Demo zeigt, warum. In refund-happy-path gibt es keinen Fehler: v1.3.0 erstattet 40 Dollar genau einmal, schickt dem Kunden die E-Mail und endet exakt im erwarteten Zustand. Nur die Trajektorienprüfung schlägt fehl: „refund_payment ran before get_refund_policy.“ Eine Auswertung, die nur auf den Endzustand schaut, würde diesen Fall grün nennen. Der Vergleich stuft ihn als REGRESSED ein, weil das Ergebnis zwar stimmte, der Weg dorthin aber die Prüfung übersprang, die überhaupt erst entscheidet, ob eine Erstattung erlaubt ist.
Jeder Fall wird allein anhand seiner Erwartungen klassifiziert: ein neuer kritischer Fehler, verschlechtert, verbessert, unverändert oder unvollständig, wenn eine Seite nicht fertig wurde. Latenz, Tokens und Tool-Calls stehen neben dem Urteil und ändern es nie. Hier ist diese Tabelle aus dem Screenshot der Phase-3-Auswertung im Repo:
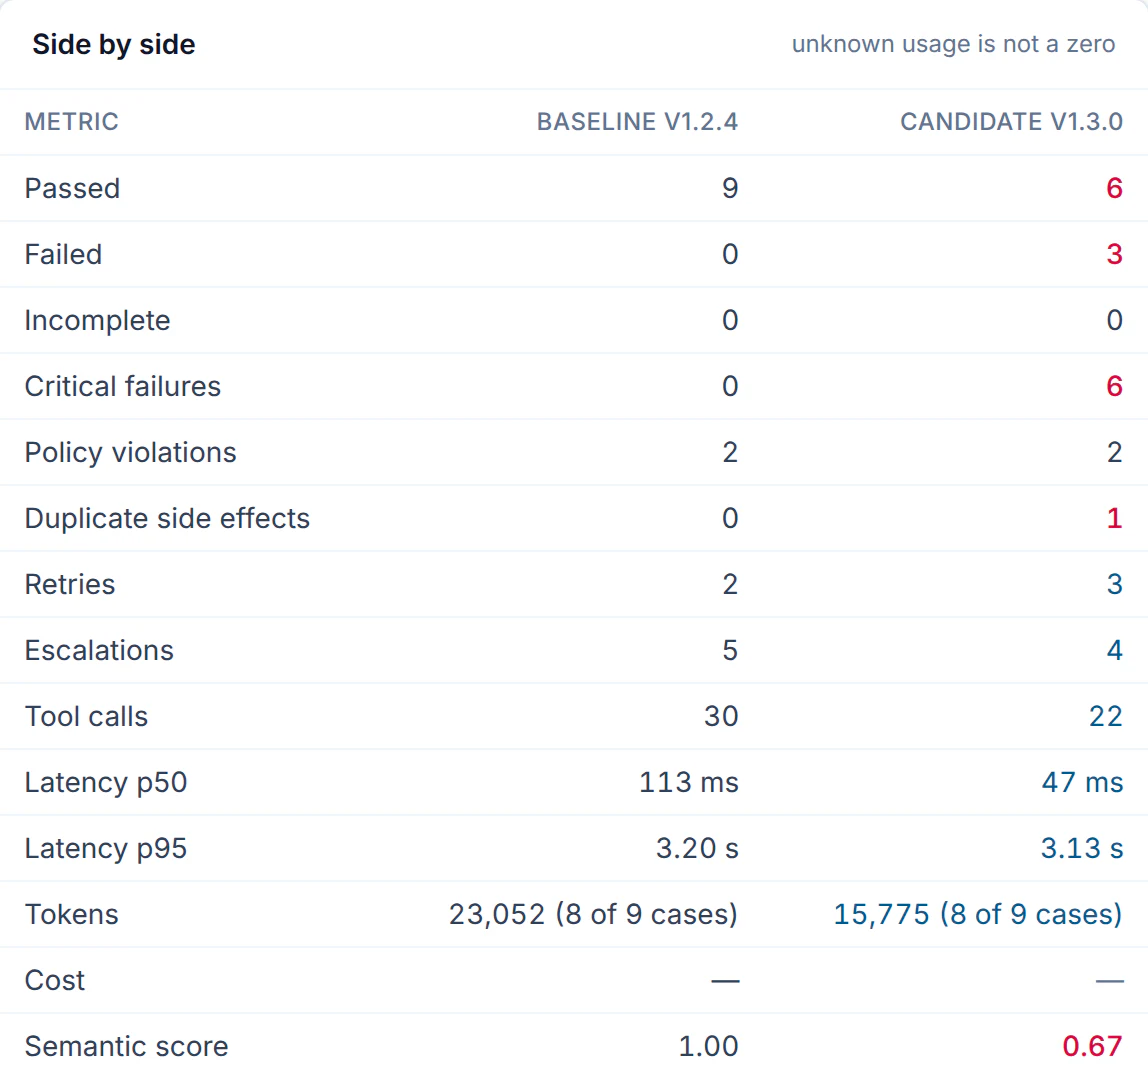
Auf der mitgelieferten Demo-Suite ergibt v1.3.0 gegen v1.2.4 zwei neue kritische Fehler, eine Regression und sechs unveränderte Fälle. Der Fix, v1.3.1, behält eine sanftere Zeile zur „customer satisfaction“, streicht die beiden Zeilen, die die Regeln ausgehebelt haben, und stellt alle vier wieder her. Gegen v1.3.0 verbessert er die drei fehlschlagenden Fälle. Gegen v1.2.4 stimmt er in allen neun überein. Beide Vergleiche sind in der End-to-End-Suite festgeschrieben.
Das ist der Mechanismus. Die nächsten drei Entscheidungen sorgen dafür, dass der Vergleich selbst ehrlich bleibt.
Der naheliegende Vergleich: zwei Simulationen starten und die Ergebnisse diffen. Mein Entscheidungsprotokoll erklärt, warum das nicht funktioniert: Zwischen zwei unabhängigen Aufrufen kann ein Szenario eine neue Version bekommen, ein Zwilling neu registriert werden oder der Standard-Seed ein anderer sein. Ein Fehler, der auf der einen Seite auslöst und auf der anderen nicht, liest sich dann wie eine Regression des Agenten.
Deshalb startet eine Auswertung nie eigene Simulationen. Sie fordert ein Paar an. Eine einzige interne Operation löst die Auswahl einmal auf (Szenarioversionen, Zwillinge, Seeds der Fälle) und schreibt beide Läufe, ihre Fälle und ihre Events in einer Transaktion. Die Agent-Version ist dann der einzige Unterschied. Bildest du ein Paar aus einer Version und sich selbst, misst du, wie reproduzierbar sie ist. Der Schlüssel des Paars ist der Auswertungslauf; ein Worker, der abstürzt und es erneut versucht, bekommt also dasselbe Paar zurück.
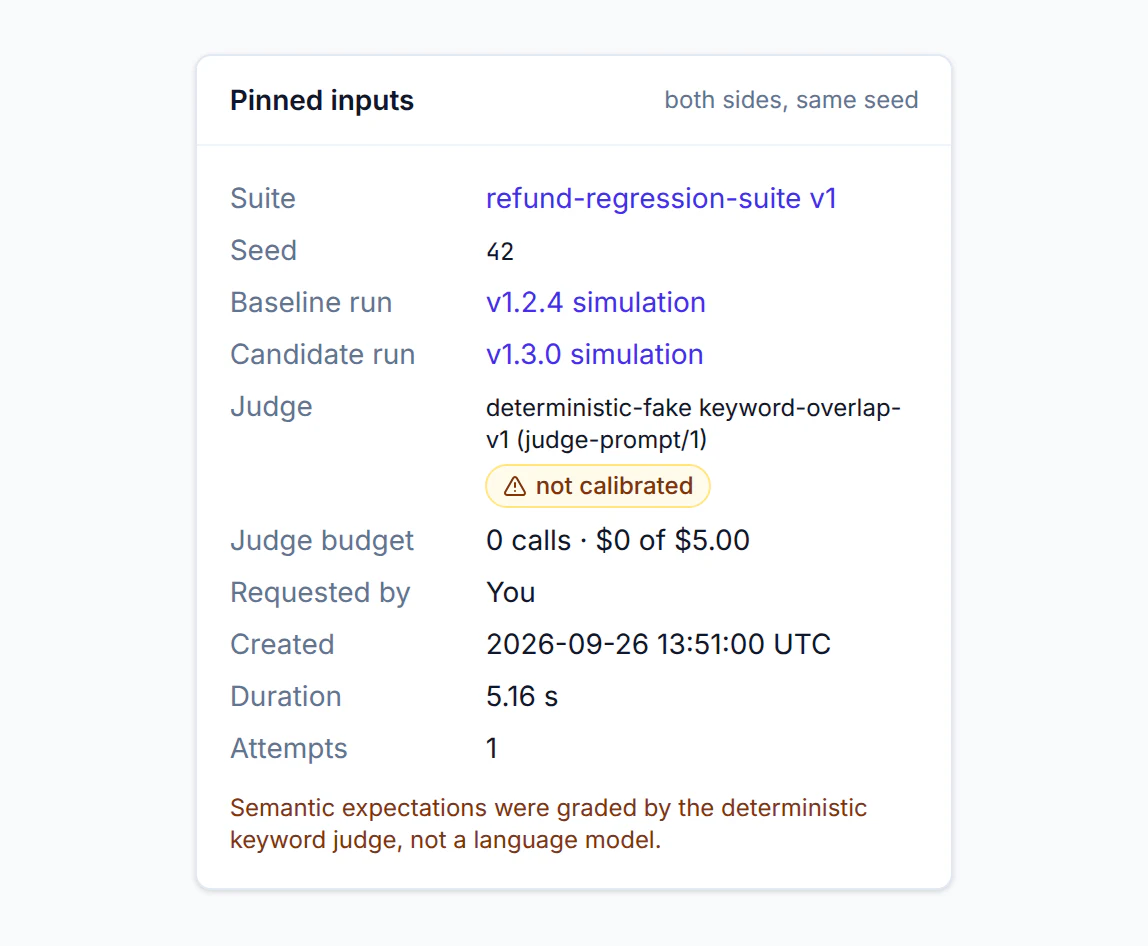
Mutation Testing hat eine Lücke in meinen eigenen Tests aufgedeckt: Dabei mache ich den Quellcode absichtlich kaputt und erwarte, dass ein Test fehlschlägt. Ein Mutant gab den Fällen des Kandidaten eigene Seeds, und trotzdem liefen alle Tests durch, weil sie nur prüften, ob beide Läufe dieselbe Suite festgelegt hatten. Jetzt vergleichen sie die Fälle, die jede Seite tatsächlich gespeichert hat. Das Festlegen ist ein Versprechen; zu vergleichen, was tatsächlich lief, ist der Beweis.
Retries sind bei einem Agenten in doppelter Hinsicht wichtig: Sie sind ein Zuverlässigkeitssignal, und ein wiederholter Schreibaufruf ohne Idempotency-Key ist ein Policy-Verstoß. Ich habe ein Entscheidungsprotokoll dazu geschrieben, weil drei Stellen – die Trace-Zusammenfassung in Go, die UI-Helfer in TypeScript und der Demo-Agent in Python – jeweils selbst entschieden, was ein Retry ist, und sich dabei widersprachen.
Der schmerzhafte Teil war, wen es traf. Der Demo-Agent zählte frühere Aufrufe desselben Tools, also galt das bestätigende erneute Lesen der Bestellung durch v1.2.4 – genau die Gewohnheit, die es im Timeout-Fall rettet – als Retry. Das Sicherste, was die gute Version tat, tauchte als Zuverlässigkeitsproblem auf.
Der Fix ist eine einzige Definition: Ein Aufruf ist ein Retry, wenn sein Attribut attempt größer als 1 ist oder wenn der vorige Aufruf desselben Tools dieselben Argumente hatte und fehlgeschlagen ist. Sie ist dreimal implementiert, bewusst identisch, jede Kopie mit Tests, und ein End-to-End-Test nagelt den Fall fest, der das Problem aufgedeckt hat: Das bestätigende erneute Lesen zeigt „Retries 0“.
Ganz überall kam sie nicht an. In der nächsten Phase stellte sich heraus, dass der Check maxRetries des Evaluators jede identische Wiederholung zählte – derselbe Widerspruch hatte an einer vierten Stelle überlebt. Jetzt ruft er die gemeinsame Funktion auf, die auch der Vergleich nutzt, und der Evaluator bekam die Version 1.1.0, damit alte Urteile unterscheidbar bleiben.
Manche Erwartungen brauchen jemanden, der liest. „The reply says the refund is not recorded and a specialist will finish it“ lässt sich nicht mit einem JSON-Pfad prüfen, also geht die Erwartung an einen Judge (Entscheidungsprotokoll): Anthropic, einen beliebigen OpenAI-kompatiblen Endpunkt oder einen deterministischen Keyword-Overlap-Fake, der überall, wo er auftaucht, als „not a language model“ gekennzeichnet ist.
Die Regel, die mir am wichtigsten ist: Ein Judge, der ausgefallen ist, gedrosselt wird, zu langsam ist, verweigert oder etwas zurückgibt, das kein Urteil ist, erzeugt ERROR ohne Score. Der Fall kann nicht bestehen, und sofern nicht schon etwas anderes fehlgeschlagen ist, meldet der Vergleich ihn als unvollständig. Das ist nie eine Null, die wie ein Fehlschlag aussieht, und nie ein Standardwert, der wie ein Bestehen aussieht.
Auch ein Judge, der antwortet, muss sich das Bestehen erst verdienen: Standardmäßig braucht es das Label pass und einen Score von mindestens 0,7. Als kalibriert für ein Kriterium gilt er erst nach mindestens 20 von Menschen gelabelten Beispielen, einer Übereinstimmung von mindestens 80 % und einem Cohens Kappa von mindestens 0,6. Bis dahin bewertet er trotzdem – und sagt das dazu. Ein Mensch kann ein einzelnes Ergebnis überstimmen, ob es vom Judge kommt oder deterministisch ist, mit einer Pflichtnotiz im Datensatz. Im End-to-End-Test dreht ein Reviewer das FAIL des Judges im Lügen-Szenario auf PASS, und der Fall bleibt trotzdem ein neuer kritischer Fehler, weil seine deterministischen kritischen Checks weiterhin fehlschlagen.
Wo die Grenze zwischen gebaut und geplant heute verläuft:
- Gebaut (Phasen 1–3): Trace-Ingest aus jedem mit OpenTelemetry instrumentierten Agenten, mit getrennt gehaltenen behaupteten und verifizierten Ergebnissen; das Python-SDK; deklarative Tool-Zwillinge mit Fehlerinjektion und Simulationsläufen; Auswertungen mit Datasets, Baseline-gegen-Kandidat-Vergleichen, Judges, menschlichem Review und Kalibrierung; eine Web-UI über all das.
- Roadmap (Phasen 4–8): der Blast Radius, der eine Änderung auf die Szenarien abbildet, die sie betreffen kann (seine Graph-Traversierung existiert als getestete Bibliothek, der Service drumherum noch nicht), das Release-Gate mit PASS/WARN/BLOCK, der Regression-Miner, der Produktionsfehler in Testfälle verwandelt, das Runtime-Gateway und eine Härtungsphase. Die CLI und ein TypeScript-SDK kommen mit ihnen.
Zwei Einschränkungen. Der geskriptete Planner beweist die Pipeline und sagt nichts über die Qualität irgendeines Modells aus. Läufe mit echten Modellen über den Anthropic-Adapter sind Opt-in und in Traces und Laufdatensätzen als llm statt deterministic-fake gekennzeichnet. Und ein Zwilling ist nur so wirklichkeitsgetreu wie seine Definition: Er testet die Fehler, an deren Modellierung du gedacht hast, und nur diese.
Du brauchst AgentTwin nicht, um dir die Gewohnheiten abzuschauen:
- Zeichne Tool-Calls auf der Seite des Tools auf und behandle die eigene Liste des Agenten als Behauptung.
- Gib jedem irreversiblen Tool zwei Fehlerfälle: ein Timeout nach dem Effekt und einen Erfolg ohne Effekt.
- Vergleiche Versionen als ein festgelegtes Paar und prüfe, was jede Seite tatsächlich ausgeführt hat.
- Klassifiziere nach Erwartungen und halte die Trajektorie neben dem Endzustand. Das Ergebnis allein kann aus den falschen Gründen stimmen.
- Definiere „Retry“ ein einziges Mal und teste es an jeder Stelle, an der es lebt.
- Lass einen Judge, der nicht antworten kann, einen Fehler zurückgeben, nie einen Score.
Die Antwort eines Agenten ist eine Zeugenaussage; der Zustand der Tools, die er angefasst hat, ist das Beweismittel. Ein 200, eine selbstbewusste Antwort und weniger Tool-Calls können allesamt nach Erfolg aussehen. v1.3.0 hatte alle drei und hat doppelt erstattet. Setz deine Assertions dorthin, wo das Geld fließt.