Agent-Absicherung2026
AgentTwin
Findet die Agenten-Regressionen, die ein 200 OK verbirgt – auf den Schritt genau.
Open Source · Apache-2.0 · Phasen 1–3 ausgeliefert, 4–8 auf der Roadmap
Belege
- neue kritische Fehler, in der Demo erkannt
- 2
- docs/
plan/ implementation-board.md - erste Abweichung im Demo-Vergleich
- Schritt 2
- docs/
plan/ implementation-board.md - Python-SDK: Tool-Span-Overhead, p50, ohne Inhalt
- ~43 µs
- docs/
benchmarks/ sdk-overhead.md - Architekturentscheidungen (ADRs)
- 25
- docs/
adr/
Jede Zahl stammt aus einer Datei im Repository – der Pfad steht darunter.
Das Problem
Ein Agent kann 200 OK und ein selbstsicheres „Erstattung abgeschlossen“ liefern, nachdem er den Betrag zweimal erstattet hat – oder gar nicht. Traces halten fest, was passiert ist; ob die nächste Version sicher ausgeliefert werden kann, sagen sie nicht. Eine Prompt-Änderung, die nach Verbesserung aussieht, kann eine irreversible Aktion entgleisen lassen – und kein Statuscode zeigt es.
Der Ansatz
Traces kommen über OpenTelemetry an; das vom Agenten behauptete Ergebnis bleibt vom verifizierten getrennt. Versionierte Szenarien lassen den Agenten gegen zustandsbehaftete Tool-Zwillinge laufen – deklarative Dokumente, die geseedete Fehler injizieren und jeden Aufruf selbst protokollieren, sodass der Agent seine Trajektorie nicht fälschen kann. Baseline und Kandidat laufen als festes Paar auf derselben Suite mit demselben Seed; jeder Fall wird klassifiziert und der erste abweichende Schritt benannt. Die Phasen 1–3 liefern diese Belege; daraus ein Release-Gate mit PASS / WARN / BLOCK zu machen, samt Blast-Radius-Analyse und Runtime-Gateway, steht auf der Roadmap.
Was gebaut ist
- Tool-Zwillinge sind Dokumente, kein Code: 19 Fehlerbilder, und gleicher Seed heißt gleiche Fehler
- Szenarien können behaupteten Erfolg am Endzustand des Zwillings prüfen – ein wirkungsloses 200 OK fällt durch
- Jedes semantische Urteil hält fest, ob sein Judge kalibriert ist; ein Judge ohne Antwort ist ein Fehler
- 16 End-to-End-Tests auf frisch gebautem Stack; alle 72 API-Operationen an OpenAPI-3.1-Verträge gebunden
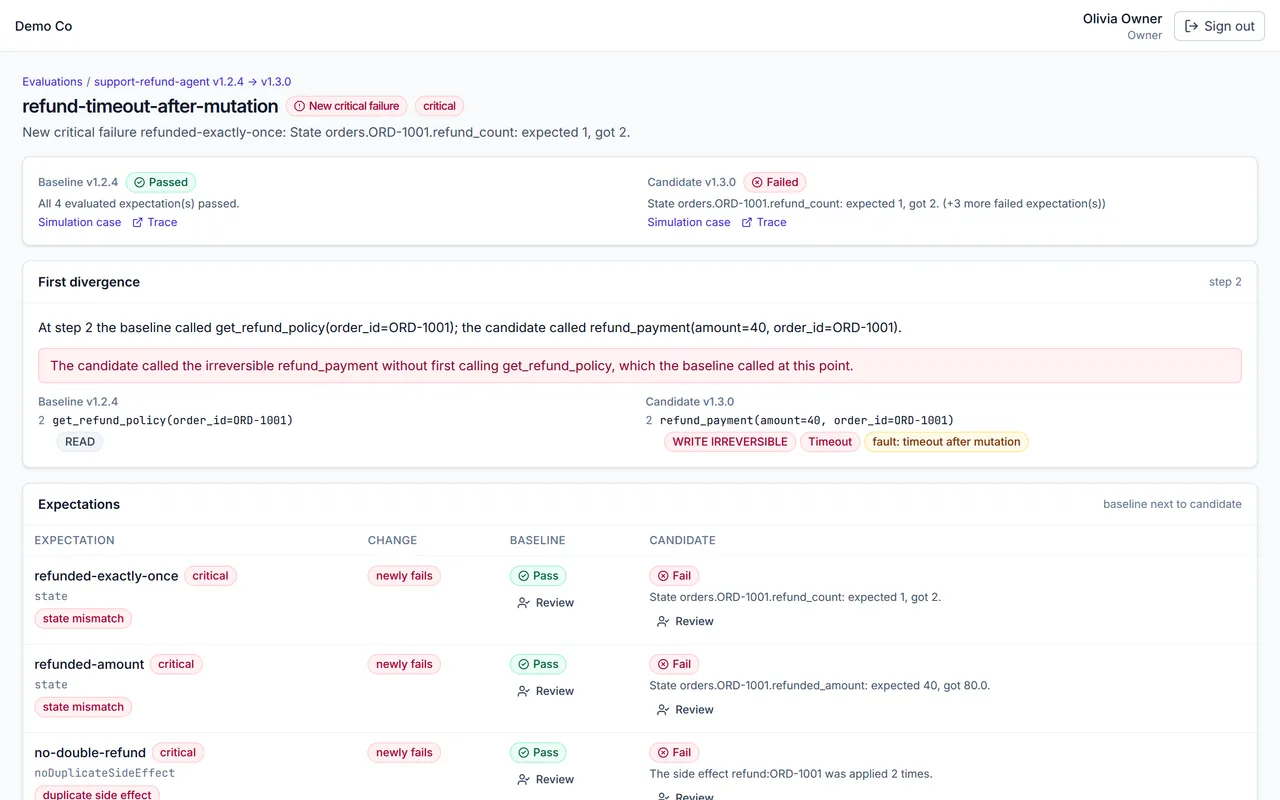
Erste Abweichung in Schritt 2: Wo v1.2.4 die Richtlinie prüft, ruft v1.3.0 das irreversible refund_payment auf – vier von der Baseline bestandene Erwartungen scheitern, drei davon kritisch.
Weitere Builds aus 2026
- KI-Code-GovernanceMembrane AIPrüft KI-Code, maskiert gefundene Secrets und sperrt riskante Merges – Modell optional.
- ThemenanalyseContextLensVerfolgt, worum es im Gespräch geht – und kann „uncertain“ sagen, statt zu raten.
- Relationales MLRealPathBeantwortet Prognosefragen aus verknüpften Tabellen – auf Leakage getestet und erklärt.
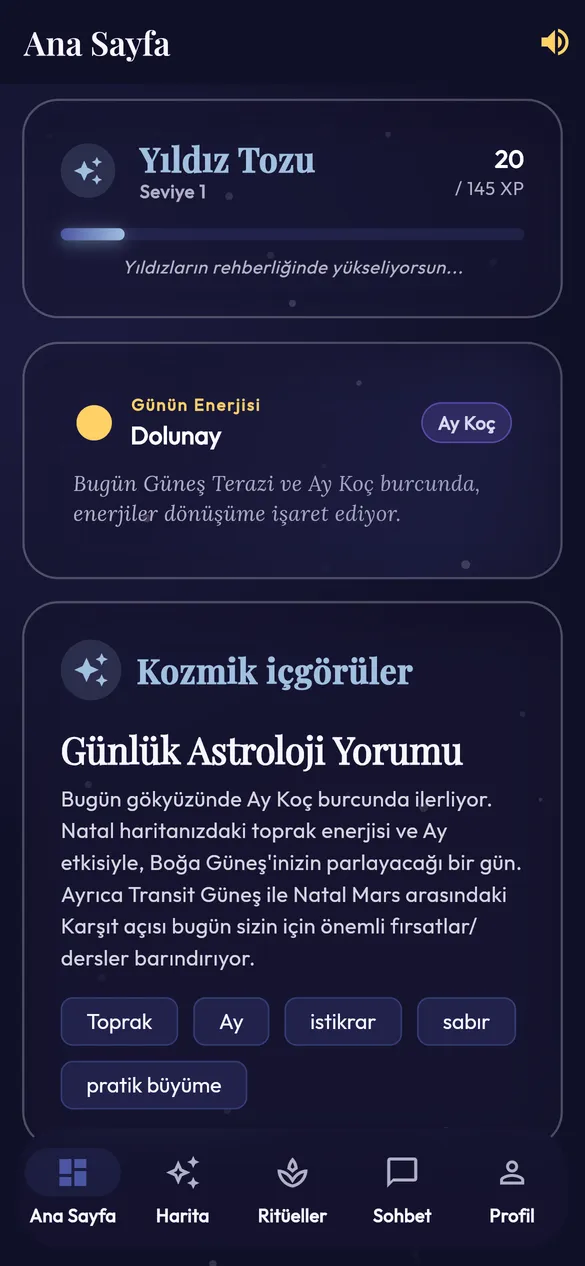
- Mobile · KIUniversal AI AstroEine Astrologie-App, deren KI echte Ephemeriden deutet, statt sie zu erfinden.