Themenanalyse2026
ContextLens
Verfolgt, worum es im Gespräch geht – und kann „uncertain“ sagen, statt zu raten.
Open Source · Apache-2.0 · Modell v1.1.0
Belege
- Makro-F1, 8 Oberthemen, gesperrtes Wikipedia-Holdout
- 0,838
- reports/
locked/ results.json - Klassifikationslatenz (Median), 4 vCPUs, ohne GPU
- 19,9 ms
- reports/
locked/ results.json - Off-Topic-AUROC auf Assistenten-Chat
- 0,961
- reports/
locked/ results.json - Gesamtgröße des Modells, Encoder inklusive
- 47 MB
- README.md
Jede Zahl stammt aus einer Datei im Repository – der Pfad steht darunter.
Das Problem
Ein Softmax-Klassifikator liefert immer ein Thema: Auf „I'm going to order pizza tonight“ antwortet auch das Modell unter ContextLens mit Books, 53,0 %. Im Gespräch ist das schlimmer als Schweigen, denn ein verirrtes Label lenkt das Thema. Und ein Modell, das nur anhand von Lexikonartikeln ausgewählt wurde, kann die Rangliste anführen und trotzdem an den kurzen Fragen scheitern, die Menschen tatsächlich tippen.
Der Ansatz
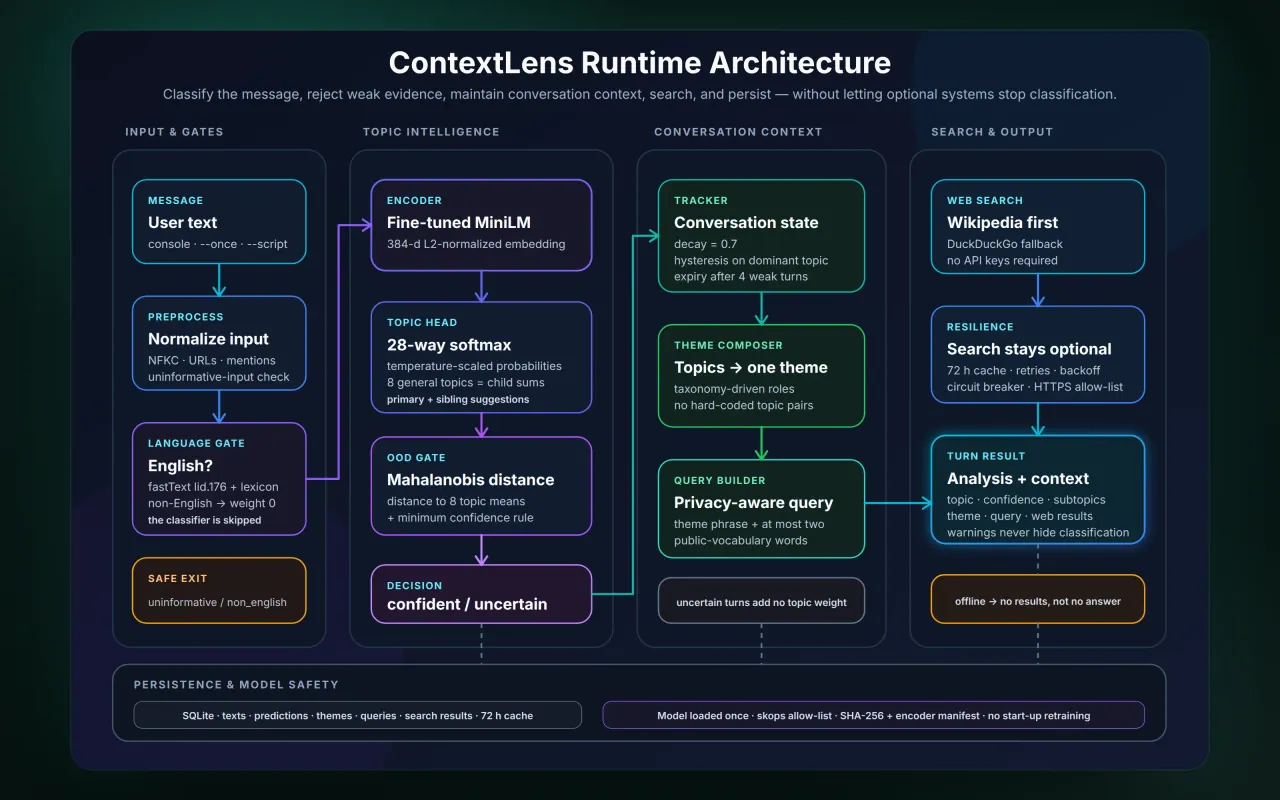
Keiner der neun geprüften Datensätze deckte die Taxonomie aus 8 Ober- und 28 Unterthemen ab; also entstand ein Korpus aus 40.112 englischen Wikipedia-Passagen, gelabelt über Wikipedias eigenen Kategoriengraphen. Ein feinabgestimmter MiniLM-Encoder speist einen einzigen temperaturskalierten Softmax über die 28 Unterthemen; ein Mahalanobis-Distanz-Gate, eine Konfidenzschwelle von 50 % und ein fastText-Sprachgate entscheiden, wann die Antwort „uncertain“ oder „not English“ lautet. Nur eindeutig zugeordnete Nachrichten fließen ins Gesprächsthema: Es klingt ab, verfällt nach vier Runden ohne eindeutige Zuordnung und wechselt seinen Schwerpunkt nach zwei übereinstimmenden Nachrichten – um den Preis, dass ein echter Themenwechsel etwa 0,6 Runden später erkannt wird. Jede Entscheidung fiel auf Entwicklungsdaten, echte Stack-Exchange-Fragen eingeschlossen; die finalen Werte stammen aus einem gesperrten Holdout, bewertet erst, nachdem die Konfiguration per Fingerabdruck eingefroren war.
Was bereits steht
- Sagt „uncertain“ bei 78,1 % des themenfremden Assistenten-Chats, aber nur bei 48,5 % themenfremder Fragen; erkennt 96,7 % nicht englischer Sätze
- Nicht nur nach Wikipedia gewählt: mpnet-base, dort gleichauf, ist 4,9-mal langsamer und bei Fragen schwächer
- Gesperrtes Holdout, bewertet nach SHA-256-Freeze; es lief zweimal, beide Läufe sind samt Grund öffentlich
- In simulierten Gesprächen kapert ein einzelner Abstecher das Thema nur noch in 10,4 % der Fälle statt in 48,8 %
Architektur
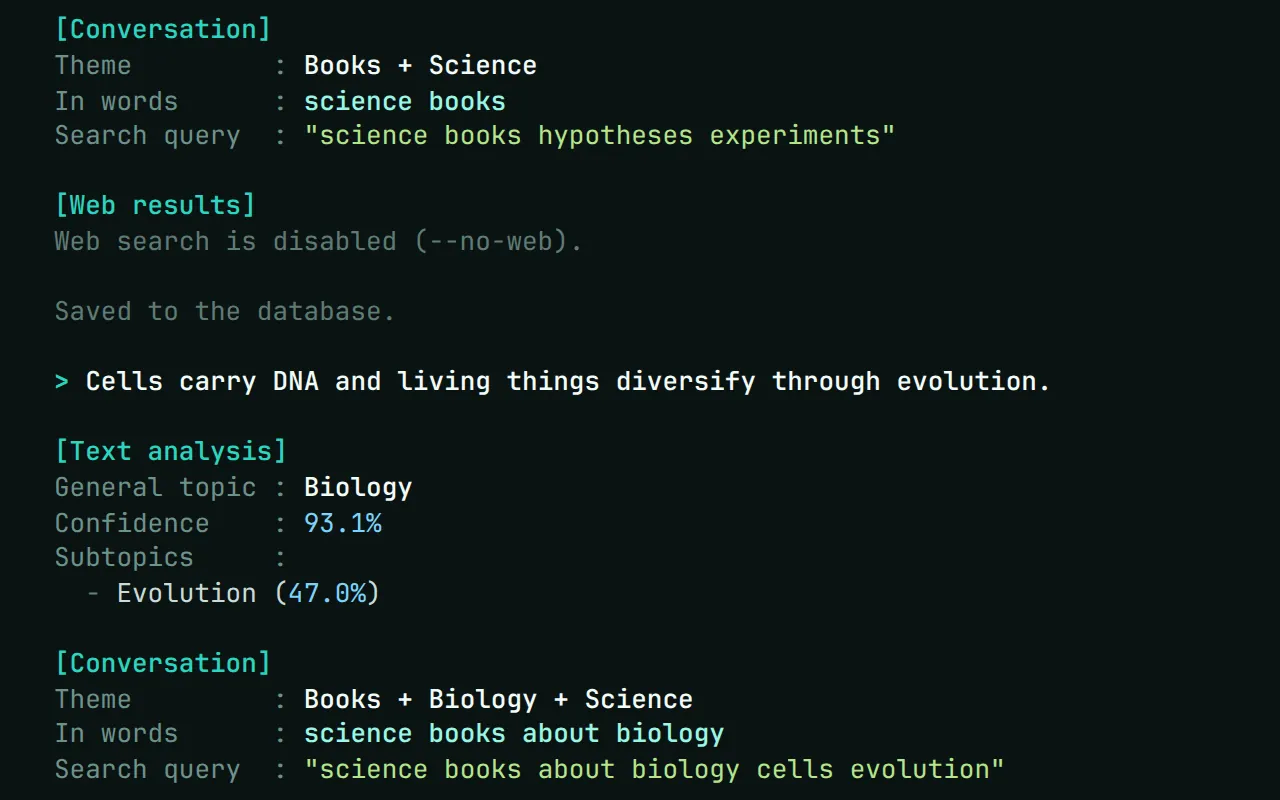
Echter CLI-Lauf der README-Demo: Roman, wissenschaftliche Methode und Evolution erhalten je Ober- und Unterthema samt Konfidenz und ergeben „science books about biology“ für die Suche.
Weitere Projekte aus 2026
- KI-Code-GovernanceMembrane AIPrüft KI-Diffs, maskiert gefundene Secrets und bewacht den Merge – Modelle optional.
- Relationales MLRealPathBeantwortet Prognosefragen aus verknüpften Tabellen – auf Leakage getestet und erklärt.
- Agent-AbsicherungAgentTwinFindet die Agenten-Regressionen, die ein 200 OK verbirgt – auf den Schritt genau.
- Mobile · KIUniversal AI AstroEine Astrologie-App, deren KI mit der Swiss Ephemeris berechnete Horoskope deutet.