12 Min. Lesezeit
Zukunft löschen, Features diffen: „kein Leakage“ als Test statt als Slogan
RealPaths Leakage-Versprechen ist ein pytest: alles nach dem Anker löschen, neu bauen, diffen. Was der Test fand, als ich den Cutoff kaputt machte – und zwei Lecks, die er noch übersieht.
Die lehrreichste Zahl in der Geschichte von RealPath ist eine, die ich nicht verwenden kann. Auf einem öffentlichen relationalen Benchmark – der Aufgabe driver-dnf im Datensatz rel-f1 von RelBench – erreichte das experimentelle Graph-Neural-Network-Backend eine ROC-AUC von 0,76. Das liegt über den rund 0,72, die die Benchmark-Notizen des Projekts für RelBenchs eigenes Referenzmodell angeben.
Die Zahl hatte nur einen Haken: Leakage. Das zeitbewusste Sampling der Nachbarknoten im GNN braucht pyg-lib, und dafür gibt es keinen Windows-Build. Auf meinem Rechner wählte das GNN seine Nachbarn deshalb aus, ohne auf deren Zeitstempel zu achten, und eine Vorhersage zu einem bestimmten Datum konnte auf Zeilen zugreifen, die erst danach entstanden waren. Die Handover-Notizen führen die Zahl unter „LEAKY, adil değil“: undicht, nicht fair.1
So sieht Leakage von außen aus. Kein Fehler. Eine Zahl, über die du dich freust.
Kein Test hat Alarm geschlagen. Für den GNN-Pfad gibt es keinen, und markiert wurde die Zahl nur, weil der Fallback bekanntermaßen undicht ist (ADR-011). RealPaths Standard-Pipeline hat dagegen einen. Er macht aus „kein Leakage“ einen pytest: jede Zeile nach dem Vorhersagedatum löschen, die Features neu bauen, diffen. In diesem Beitrag geht es um diesen Test, darum, was er fand, als ich den Code absichtlich kaputt machte, und um die zwei Lecks, die ihm immer noch durchrutschen.
RealPath ist eine Local-First-Vorhersage-Engine für relationale Datenbanken. Du richtest sie auf DuckDB (oder über optionale Konnektoren auf Postgres und MySQL) und fragst etwa: „Welche Kunden kaufen in den nächsten 30 Tagen nichts?“ RealPath übersetzt die Frage in eine Vorhersageaufgabe, baut mit Featuretools Features entlang der Fremdschlüssel, trainiert LightGBM und erklärt jeden Score über seinen Join-Pfad. Das Entscheidungsprotokoll nennt Leakage den heimtückischsten Fehler relationaler Vorhersage. ADR-005 ergänzt – meine Übersetzung aus dem Türkischen –, dass „kein Leakage“ kein Slogan sein dürfe, sondern eine prüfbare Garantie sein müsse.
In einer einzelnen flachen Tabelle ist Leakage meist eine Spalte, die du zu entfernen vergessen hast. In einer relationalen Datenbank ist es ein Join. Um vorherzusagen, ob ein Kunde in den nächsten 30 Tagen nichts mehr kauft, brauchst du seine Historie: Umsatz, Kaufhäufigkeit, Retouren. Jede dieser Größen ist eine Aggregation über eine verknüpfte Tabelle, etwa SUM(transactions.amount) oder MEAN(returns.transactions.amount). Berechnest du sie über alle Transaktionen, enthält sie stillschweigend die nächsten 30 Tage – genau das Fenster, in dem das Label gemessen wird. Das Modell schreibt beim Training aus dem Lösungsheft ab und wirkt brillant, bis es der Zukunft begegnet, die es eigentlich vorhersagen sollte.
Daran ist nichts exotisch. Es ist der Normalfall: SELECT SUM(amount) FROM transactions GROUP BY customer_id weiß nicht, von welchem Datum aus du vorhersagst. Deshalb wollte ich nicht, dass „kein Leakage“ eine Konvention ist, an die jede Query selbst denken muss. Es musste in der Struktur stecken – und es musste sich prüfen lassen.
Eine Frage an RealPath, formuliert in seiner Predictive Query Language (PQL), sieht so aus:
PREDICT COUNT(transactions.*, 0, 30, days) == 0
FOR EACH customers.customer_id
Zähle für jeden Kunden die Transaktionen zwischen 0 und 30 Tagen nach einem bestimmten Zeitpunkt und sage vorher, ob diese Anzahl null ist. Welcher Zeitpunkt, verrät die Query absichtlich nicht. Dieser Zeitpunkt ist der Anker, und er gehört dem Compiler. pql/compile.py macht aus Query und Anker eine einzige SQL-Anweisung. Für die Churn-Frage zum Anker 2025-03-01 schickt es Folgendes ab (Parameter eingesetzt, Quoting und Sortierung gekürzt, Kommentare von mir):
WITH universe AS (         -- customers that exist at the anchor
  SELECT customers.customer_id AS _eid
  FROM customers
  WHERE customers.signup_date <= '2025-03-01'
),
events AS (                -- their purchases in (anchor, anchor + 30 days]
  SELECT customers.customer_id AS _eid, COUNT(*) AS _val
  FROM customers
  JOIN transactions ON customers.customer_id = transactions.customer_id
  WHERE transactions.tx_time >  '2025-03-01'
    AND transactions.tx_time <= '2025-03-31'
  GROUP BY customers.customer_id
)
SELECT u._eid AS entity_id, COALESCE(e._val, 0) AS agg_value
FROM universe u
LEFT JOIN events e ON u._eid = e._eid
Die Arbeit erledigen zwei Filter. Die Grundgesamtheit (universe) enthält nur Kunden, deren eigener Zeitstempel signup_date am oder vor dem Anker liegt – wer sich erst nächsten Monat registriert, kann also nicht Teil der Frage für diesen Monat sein. Die Events sind Zielzeilen im Intervall (anchor + start, anchor + end]: hier nach dem Anker und höchstens 30 Tage später. Kunden ohne Events bekommen über LEFT JOIN und COALESCE eine Null, und beim Churn ist genau diese Null die positive Klasse.
Die Features stammen von der anderen Seite desselben Zeitstempels. build_split liefert außerdem eine Cutoff-Tabelle: eine Zeile pro Kunde, gestempelt mit dem Anker. features.py übergibt sie der Deep Feature Synthesis (DFS) von Featuretools als cutoff_time, und DFS aggregiert nur Zeilen, die am oder vor diesem Zeitpunkt liegen. Features sehen t ≤ anchor, Labels sehen anchor < t ≤ anchor + 30 days, und die beiden Fenster überschneiden sich nie. Eine Transaktion, die genau auf den Anker fällt, zählt zur Historie.
Auch die Anker wählt der Compiler. Er liest die Zeitspanne der Zieltabelle, setzt den Testanker einen Horizont (hier 30 Tage) vor den letzten Zeitstempel und den Trainingsanker noch einen Horizont davor. Das Modell lernt aus einem 30-Tage-Fenster und wird am darauffolgenden bewertet. In der Beispieldatenbank sind das 2025-04-29 und 2025-05-29, und realpath predict gibt beide aus.
Laut ADR-005 bekommt jede Entität einen Anker. In der Praxis stempelt ein Split jede Zeile mit demselben. Featuretools würde auch einen Zeitpunkt pro Zeile akzeptieren; bisher nutzt das nur RealPaths RelBench-Adapter, und zwar mit dem eigenen Zeitstempel jeder Aufgabenzeile.
Die Idee hinter tests/test_leakage.py passt in einen Satz: Wenn die Features zu einem Anker wirklich nur von Zeilen am oder vor dem Anker abhängen, kann das Löschen aller späteren Zeilen sie nicht verändern. Also löscht der Test sie.
def test_no_future_leakage(sample_db, tmp_path):
    anchor = pd.Timestamp("2025-03-01")

    X_full, _ = _build_split_and_features(sample_db, PQL, anchor)

    trunc_path = tmp_path / "trunc.duckdb"
    _truncated_db(sample_db, anchor, trunc_path)
    X_trunc, _ = _build_split_and_features(str(trunc_path), PQL, anchor)

    common_idx = X_full.index.intersection(X_trunc.index)
    common_cols = X_full.columns.intersection(X_trunc.columns)
    assert len(common_idx) > 100 and len(common_cols) > 5

    a = X_full.loc[common_idx, common_cols]
    b = X_trunc.loc[common_idx, common_cols]
    # identical => no feature depended on post-anchor rows
    mismatches = []
    for col in common_cols:
        if not _series_equal(a[col], b[col]):
            mismatches.append(col)
    assert not mismatches, f"Future data leaked into features: {mismatches}"
Er baut die Churn-Features auf der synthetischen Beispieldatenbank zum 2025-03-01. Dann kopiert er die Datenbank ohne jede Zeile, deren Zeitindex nach dem Anker liegt, und baut auf der Kopie dieselben Features. Verglichen werden die beiden Matrizen auf den Zeilen und Spalten, die sie gemeinsam haben. Numerische Spalten müssen bis auf Gleitkomma-Rauschen übereinstimmen (np.allclose mit einer relativen Toleranz von 1e-6), alles andere muss als String identisch sein.
Der Docstring verspricht „byte-for-byte identical“, also mehr, als die Assertion tatsächlich prüft. Ich halte die Assertion für richtig: Gleitkomma-Aggregationen schulden dir keine Bitstabilität. Die Guards > 100 und > 5 sorgen dafür, dass ein Vergleich über gar nichts nicht bestehen kann.
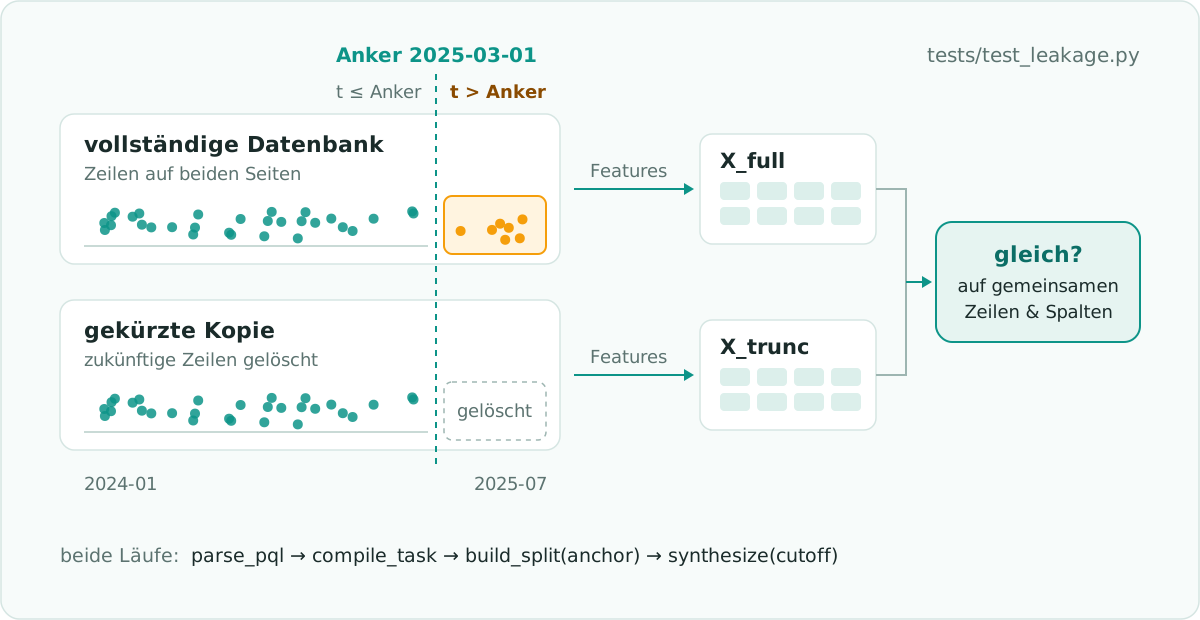
Am meisten gefällt mir, was der Test alles nicht weiß: was DFS ist, wie cutoff_time funktioniert, welche Primitive es gibt. Beginnt ein neues Primitiv, ein tieferer Join-Pfad oder ein Bibliotheks-Upgrade, die Zeilen von morgen zu lesen, nennt die Liste der Abweichungen die betroffenen Spalten trotzdem. Die Designspezifikation des Projekts (v2) hatte Größeres versprochen: einen Auditor, der jedes Feature bis zu seinen Quellzeilen zurückverfolgt. Gebaut wurde er nie. Gebaut wurde etwas Dümmeres – und, wie ich finde, Besseres: eine Blackbox-Prüfung des Verhaltens.
Ein Test, der nicht scheitern kann, beweist nichts – also habe ich versucht, diesen hier scheitern zu lassen. In einer Wegwerfkopie des Repositorys habe ich den getesteten Code jeweils an einer einzigen Zeile geändert und nach jeder Änderung pytest tests/test_leakage.py laufen lassen. Keine dieser Änderungen ist committet, und jede ist klein genug, um sie von Hand nachzustellen:
| Einzeilige Änderung | pytest | Leck erkannt? |
|---|---|---|
| keine (Auslieferungszustand) | 2 passed | — |
features.py: kein Cutoff (cutoff_time=None) | 1 failed, 1 passed | ja |
features.py: Cutoff bei Anker + 30 Tage | 1 failed, 1 passed | ja |
features.py: Cutoff bei Anker + 1 Tag | 1 failed, 1 passed | ja |
compile.py: Filter „existiert zum Anker“ aus | 2 passed | nein |
Ohne Cutoff aggregierte DFS über die gesamte Datenbank. Jedes Aggregat über Transaktionen und Retouren änderte sich; übereinstimmend blieben nur die eigenen Spalten des Kunden: Land, Segment sowie Monat und Wochentag des Registrierungsdatums. Lag der Cutoff am Ende des Label-Fensters – der Klassiker, bei dem man um genau ein Fenster danebenliegt –, scheiterte der Test mit derselben Liste. Dann die kleinste Änderung, ein Tag zu spät:
-        cutoff_time=cutoff,
+        cutoff_time=cutoff.assign(time=cutoff["time"] + pd.Timedelta(days=1)),
Die Fehlermeldung, umbrochen und gekürzt:
E       AssertionError: Future data leaked into features:
        ['MAX(transactions.amount)', 'MAX(transactions.quantity)',
         'MEAN(transactions.amount)', …, 'MAX(returns.transactions.amount)',
         'MEAN(returns.transactions.amount)', …]
FAILED tests/test_leakage.py::test_no_future_leakage - AssertionError: Future...
1 failed, 1 passed
Ein einziger Tag an Zukunftszeilen reichte, um die Matrix zu verändern. Erst dieses Ergebnis hat mich dem Test vertrauen lassen.
Ein Leakage-Test, den du nie hast scheitern sehen, ist kein Beleg. Er ist Dekoration.
Die vierte Änderung kam durch. Ich hatte den universe-Filter abgeschaltet, also die Bedingung signup_date <= anchor, die spätere Registrierungen aus der Frage heraushält – und beide Tests blieben grün.
In der Feature-Matrix der vollständigen Datenbank tauchten nun Kunden auf, die sich erst nach dem Anker registriert hatten. In der gekürzten Kopie gibt es sie nicht, und verglichen wird über X_full.index.intersection(X_trunc.index). Die Schnittmenge hat genau die falschen Zeilen stillschweigend aussortiert. Der Guard > 100 verhindert einen Vergleich über nichts, aber keinen Vergleich über weniger.
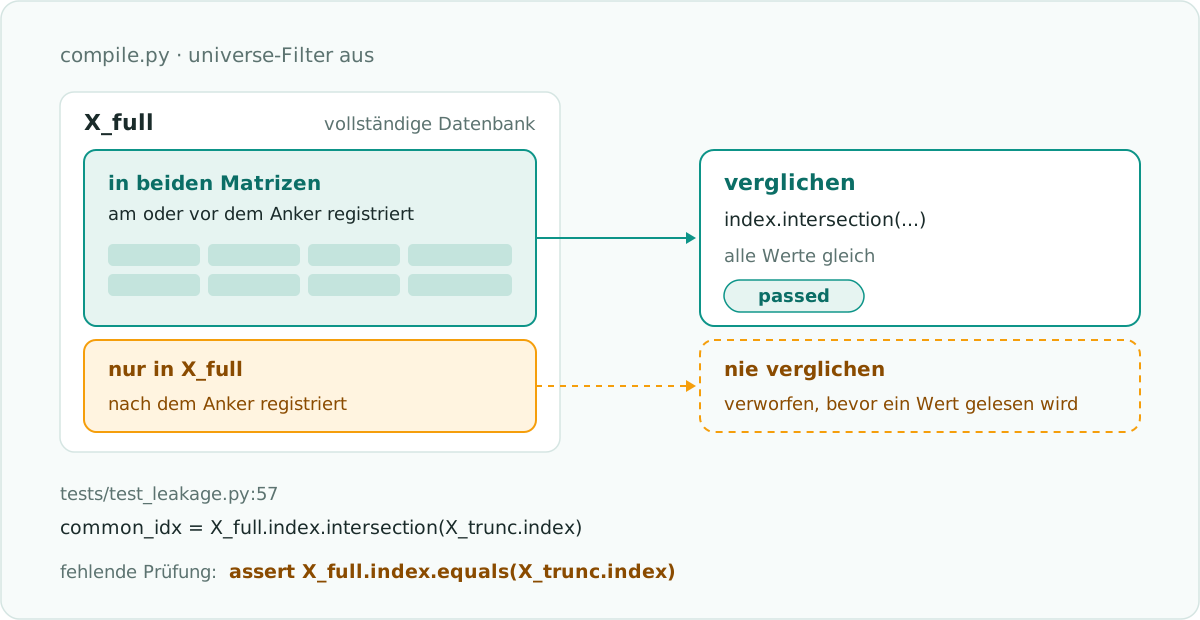
Das ist ein Populationsleck: Trainiert wird auf Kunden, die es zum Anker noch gar nicht gibt. Die Lösung sind zwei Assertions, bevor überhaupt ein Wert verglichen wird. Im Repository stehen sie noch nicht:
assert X_full.index.equals(X_trunc.index), "entities differ: population leak"
assert X_full.columns.equals(X_trunc.columns), "feature columns differ"
Auf dem ausgelieferten Code halten beide. Mit abgeschaltetem universe-Filter scheitert die erste.
Die zweite Lücke hat nichts mit dem Feature-Code zu tun. Sie steckt in der Frage.
Die Grammatik akzeptiert negative Fenstergrenzen (das Muster im Parser dafür ist -?\d+), und nichts weiter hinten in der Pipeline weist sie zurück. Also habe ich von Hand eine Query geschrieben, die rückwärts schaut:
PREDICT COUNT(transactions.*, -30, 0, days) == 0
FOR EACH customers.customer_id
Das bedeutet: „Kunden ohne Kauf in den 30 Tagen vor dem Anker.“ So etwas kannst du zum Vorhersagezeitpunkt einfach nachschlagen; eine Prognose ist das nicht. Die Query ließ sich kompilieren, das Modell trainierte und meldete ein perfektes Ergebnis. So sah die Ausgabe von realpath predict aus, gekürzt:
[realpath] anchors: train=2025-06-28 test=2025-06-28
metrics: roc_auc=1.0000  accuracy=1.0000
Das perfekte Ergebnis geht auf einen zweiten Bug zurück. Ein Fenster, das am Anker endet, bekommt einen Horizont von null Tagen (horizon_days nimmt abs(end)). Beide Anker landen also auf demselben Datum, und das Modell wird auf genau den Zeilen bewertet, auf denen es trainiert hat. Dasselbe Symptom wie beim GNN am Anfang: kein Fehler, nur eine Zahl, über die du dich freust. An den beiden Ankern der Churn-Query ist die Rückwärtsfrage weit davon entfernt, perfekt zu sein. Sie bleibt trotzdem eine Frage über die Vergangenheit.
Der Löschtest bleibt bei dieser Query grün, denn die Features sind tatsächlich sauber. Der zweite Test in der Datei, test_label_window_is_in_the_future, prüft genau die fehlende Eigenschaft und scheitert, wenn ich diese Query in seine PQL-Konstante einsetze. Er läuft aber immer nur gegen seine eigene, fest einprogrammierte Frage. Die Prüfung lebt in der Testsuite, nicht im Compiler, durch den jede echte Query läuft.
Das ist wichtig, weil die meisten Fragen gar nicht als PQL ankommen werden. RealPath nimmt auch Englisch und Türkisch entgegen (ADR-007). Die Offline-Vorlagen schreiben nur Fenster nach vorn; mit API-Schlüssel schreibt dagegen Claude die PQL, und der Parser prüft sie.
Das Modell schreibt nie einen Join und wählt nie einen Zeitstempel. Anker, Grundgesamtheit und Cutoff gehören dem Compiler, und diese Aufteilung würde ich weiterhin verteidigen. Das Fenster aber wählt das Modell. Sein Prompt zeigt nur vorwärtsgerichtete Beispiele und sagt nirgends, dass ein Fenster nicht unter null beginnen darf, und das erneute Parsen prüft die Syntax, nicht das Tempus. „Die letzten 30 Tage“ – so käme ein Rückwärtsfenster an, und hinter dem Parser würde es nichts mehr aufhalten.
Eine einzige Prüfung im Compiler würde beide Löcher schließen – das Rückwärtsfenster und den Null-Horizont hinter dem perfekten Ergebnis:
# pql/compile.py, CompiledTask._validate(): a proposal, not in the repo
w = t.target.window
if not 0 <= w.start < w.end:
    raise PQLCompileError(
        "The label window must start at or after the anchor and end after it."
    )
In einer Wegwerfkopie besteht die komplette Suite damit weiterhin, und die Rückwärts-Query scheitert schon beim Kompilieren.
Aus den Feature-Namen, die der Test vergleicht, baut RealPath auch seine Erklärungen (ADR-006). Ein DFS-Name ist ein Join-Pfad mit einer Aggregation obendrauf. MEAN(returns.transactions.amount) heißt: Nimm für jede Retoure dieses Kunden den Betrag der Transaktion, zu der sie gehört, und bilde den Mittelwert. explain.provenance() besteht aus zwei regulären Ausdrücken, die den Namen wieder in Tabellen und eine Aggregation zerlegen, und format_card() gibt das als eine Zeile einer Karte pro Kunde aus.
Nimm die letzte Zeile der Karte für den Kunden, den das Quickstart-Notebook am höchsten bewertet: returns -> transactions: MEAN = 148.19. In Worten: Die Käufe, die dieser Kunde bis zum Anker zurückgegeben hatte, lagen im Schnitt bei 148,19. Das ist wörtlich die Berechnung hinter einer der Eingaben des Modells – und eine der Spalten, die die Ein-Tag-Änderung kaputt gemacht hat. Die Erklärung erbt alles, was der Test beweist.
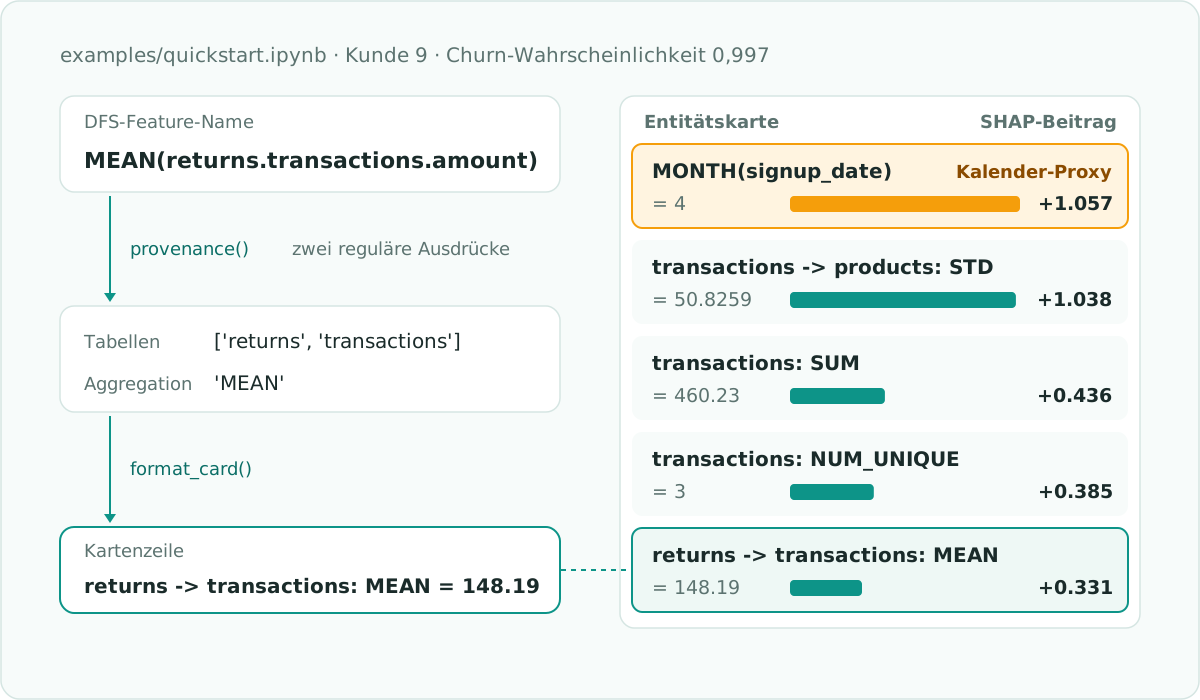
Eine Einschränkung zu dieser Karte: Ihre Beiträge sind SHAP-Werte, weil in der Umgebung des Notebooks shap installiert war (das optionale Extra explain). Ohne shap fällt die Karte auf den globalen Gain des Modells zurück, und nichts auf der Karte verrät, welche Art von Beitrag du gerade siehst.
Die oberste Zeile ist die zweite Lektion. Nach Gain ist MONTH(signup_date) der stärkste Treiber des Churn-Modells – dabei liest nichts im Datengenerator den Kalendermonat. Der Generator zieht den letzten aktiven Tag jedes abwandernden Kunden zufällig, relativ zu dessen Registrierungsdatum; die Dauer der Kundenbeziehung verschiebt also die Wahrscheinlichkeit, dass jemand bis zum Anker inaktiv geworden ist.
Unter den Primitiven gibt es month und weekday, aber nichts wie „Tage seit Registrierung“. Meine beste Erklärung: Die Bäume haben sich an den nächstbesten Anhaltspunkt gehalten, den es gab – ein Kalenderfeld, das Januar 2024 nicht von Januar 2025 unterscheiden kann. Ein Gain-Rang ist allerdings keine kausale Rangfolge, und ein kategoriales Merkmal mit 12 Stufen sammelt gern Gain ein.
Ein Leakage-Test beweist, dass das Modell nur die Vergangenheit gesehen hat. Er kann nicht beweisen, dass es daraus etwas Echtes gelernt hat – und die ROC-AUC von 0,7492, die das Notebook auf synthetischen Daten erreicht, hätte mir das nie gezeigt.
Abgesehen von den beiden Lücken oben:
- Er sieht gelöschte Zeilen, keine geänderten. Das Kürzen entfernt Zeilen nach ihrem Zeitindex, und eine Tabelle ohne Zeitindex (im Beispiel
products) wird komplett kopiert. In einer echten Datenbank ist ein Preis oder ein Segment, das an Ort und Stelle überschrieben wurde, der heutige Wert, verkleidet als Historie. Kein noch so gründliches Löschen bringt das ans Licht. Dafür braucht es Snapshots oder Historientabellen. - Er vertraut dem Zeitindex, den er testet. Kürzung und Cutoff verwenden beide die erste Zeitstempelspalte, die RealPath für jede Tabelle ableitet (ADR-010). Liegt diese Vermutung daneben, teilen beide Seiten den Fehler, und der Diff kann ihn nicht sehen.
- Er schaut nicht auf den Split. Der Test legt einen Anker fest. Nichts prüft, dass Training und Scoring verschiedene Anker nutzen – genau so konnte sich die Rückwärts-Query selbst benoten.
- Er beweist einen einzigen Fall. Ein Anker, eine Query, eine synthetische Datenbank. Ihn über die Vorlagen und ein paar Anker zu parametrisieren, wäre billig.
- Er läuft nur dort, wo pytest läuft. ADR-005 setzt darauf, dass CI die Eigenschaft nachweist, aber GitHub Actions ist auf diesem Account noch nie gelaufen (ADR-015). Das Gate ist ein lokaler Lauf.
Und das GNN vom Anfang wartet noch immer auf einen fairen Lauf. ADR-011 kennzeichnet jeden Vergleich als „temporal“ oder „leaky“, deshalb bleiben seine 0,76 aus der Benchmark-Tabelle draußen. Ein lokaler Linux-Container hat die Platte vollgeschrieben. Der nächste Plan war ein CI-Workflow – geschrieben, aber nie aktiviert, auf einem Account, auf dem Actions nicht läuft. Entscheidungsprotokoll und Handover führen die faire Zahl inzwischen als PENDING, während die Benchmark-Seite weiterhin auf CI verweist.
Das Muster hängt weder an Featuretools noch an RealPath. Jede Pipeline, die Features aus Zeilen mit Zeitstempel baut, lässt sich genauso prüfen.
RealPath liegt unter MIT-Lizenz auf GitHub: Ozgurisikdamar/RealPath. Auf PyPI ist es nicht veröffentlicht, also installierst du es aus einem Klon:
git clone https://github.com/Ozgurisikdamar/RealPath.git && cd RealPath
python -m venv .venv && source .venv/bin/activate
pip install -e ".[dev]"
pip install "setuptools<81"
python -m pytest tests/test_leakage.py -q
Unter Python 3.12+ oder in einer mit uv gebauten Umgebung enthält das venv kein setuptools, und woodwork (eine Abhängigkeit von Featuretools) importiert noch pkg_resources. Daher der Pin, der unter 3.10 und 3.11 nicht schadet. Die Änderungen aus der Tabelle sind Einzeiler in realpath/features.py und realpath/pql/compile.py. Die Rückwärts-Query läuft unverändert:
realpath make-sample
realpath predict "PREDICT COUNT(transactions.*, -30, 0, days) == 0
  FOR EACH customers.customer_id" --db data/shop.duckdb
„Kein Leakage“ ist eine Behauptung über die Zukunft, also teste sie, indem du die Zukunft löschst. Dann mach deinen eigenen Cutoff so lange kaputt, bis der Test rot wird. Vergleiche die ganzen Matrizen, nicht ihre Schnittmenge. Und setz die Richtungsprüfung dorthin, wo jede echte Frage vorbeikommt – nicht nur in die eine, die dein Test zufällig stellt. Bis dahin ist „kein Leakage“ immer noch ein Slogan. Nur eben mit grünem Haken.
Fußnoten
-
Die 0,76 sind in
docs/HANDOVER.mdfestgehalten, die Referenz von etwa 0,72 indocs/BENCHMARKS.md. Die ausgelieferte Feature-Synthese-Pipeline erreicht auf derselben Aufgabe 0,592, mit tieferen Features 0,658. Den RelBench-Pfad habe ich für diesen Beitrag nicht erneut laufen lassen. ↩