12 dk okuma
Geleceği sil, öznitelikleri karşılaştır: “sızıntı yok” bir slogan değil, bir test
RealPath'in sızıntı iddiası bir pytest: anchor'dan sonraki her şeyi sil, yeniden üret, karşılaştır. Cutoff'u bilerek bozduğumda neyi yakaladığı ve hâlâ gözünden kaçan iki sızıntı.
RealPath'in geçmişindeki en öğretici sayı, kullanamadığım bir sayı. Herkese açık bir ilişkisel benchmark'ta, RelBench'in rel-f1 veri setindeki driver-dnf görevinde, deneysel graph neural network (GNN) backend'i 0,76 ROC-AUC aldı. Bu, projenin benchmark notlarında RelBench'in kendi referans modeli için verilen yaklaşık 0,72'nin üzerinde.
Üstelik sızıntılıydı. GNN'in zamana duyarlı komşu örneklemesi pyg-lib gerektiriyor, onun da Windows sürümü yok. Bu yüzden benim makinemde komşuları zaman damgalarına bakmadan örnekledi; belli bir tarih itibarıyla yapılan bir tahmin, o tarihten sonraki satırlara uzanabiliyordu. Handover notları bu sayıyı tek bir etiketle kayda geçiriyor: "LEAKY, adil değil".1
Sızıntı dışarıdan böyle görünür. Bir hata değil. Görünce sevindiğin bir sayı.
Onu hiçbir test yakalamadı. GNN yolunun hiç testi yok; sayı yalnızca fallback'in sızdırdığı zaten bilindiği için işaretlendi (ADR-011). RealPath'in varsayılan pipeline'ında ise bir test var. "Sızıntı yok" iddiasını bir pytest'e çeviriyor: tahmin tarihinden sonraki her satırı sil, öznitelikleri yeniden üret, karşılaştır. Bu yazı o testi, kodu bilerek bozduğumda neyi yakaladığını ve hâlâ gözünden kaçan iki sızıntıyı anlatıyor.
RealPath, ilişkisel veritabanları için yerel öncelikli bir tahmin motoru. Onu DuckDB'ye (ya da opsiyonel connector'larla Postgres ve MySQL'e) bağlıyor ve "önümüzdeki 30 günde hangi müşteriler hiçbir şey satın almayacak?" gibi bir soru soruyorsun. Soruyu bir tahmin görevine derliyor, Featuretools ile yabancı anahtarlar boyunca öznitelikler üretiyor, LightGBM eğitiyor ve her skoru join yoluyla açıklıyor. Karar günlüğüne göre ilişkisel tahminde en sinsi hata label leakage, yani modelin gelecekteki satırları görerek eğitilmesi. ADR-005 de şunu ekliyor: "'Sızıntı yok' bir slogan değil, denetlenebilir bir garanti olmalı."
Tek bir düz tabloda sızıntı genellikle silmeyi unuttuğun bir kolondur. İlişkisel bir veritabanında ise bir join'dir. Bir müşterinin önümüzdeki 30 günde alışverişi bırakıp bırakmayacağını tahmin etmek için onun geçmişini istersin: harcamasını, alışveriş sıklığını, iadelerini. Bunların her biri ilişkili bir tablo üzerinde bir agregasyondur; SUM(transactions.amount) ya da MEAN(returns.transactions.amount) gibi. Birini tüm işlemler üzerinden hesaplarsan önümüzdeki 30 günü de sessizce içine alır; yani etiketin ölçüldüğü pencerenin ta kendisini. Model cevap anahtarıyla eğitilir ve tahmin etmesi gereken gelecekle karşılaşana kadar parlak görünür.
Bunun hiçbir egzotik yanı yok; varsayılan davranış zaten bu. SELECT SUM(amount) FROM transactions GROUP BY customer_id hangi tarihten tahmin yaptığını bilmez. Bu yüzden "sızıntı yok" ilkesinin, her sorgunun aklında tutması gereken bir gelenek olmasını istemedim. Yapısal olmalıydı ve kontrol edilebilmeliydi.
RealPath'e sorulan bir soru, tahmin sorgu dili PQL'de (predictive query language) şöyle görünür:
PREDICT COUNT(transactions.*, 0, 30, days) == 0
FOR EACH customers.customer_id
Her müşteri için, belli bir andan sonraki 0 ile 30 gün arasındaki işlemlerini say ve bu sayının sıfır olup olmayacağını tahmin et. Sorgu hangi an olduğunu bilerek söylemiyor. O an anchor'dır (referans anı) ve onun sahibi derleyicidir. pql/compile.py, sorguyu ve bir anchor'ı tek bir SQL ifadesine çevirir. 2025-03-01 anchor'ındaki churn sorusu için gönderdiği SQL şu (parametreler yerine yazıldı, tırnaklar ve sıralama kırpıldı, yorumlar benim):
WITH universe AS (         -- customers that exist at the anchor
  SELECT customers.customer_id AS _eid
  FROM customers
  WHERE customers.signup_date <= '2025-03-01'
),
events AS (                -- their purchases in (anchor, anchor + 30 days]
  SELECT customers.customer_id AS _eid, COUNT(*) AS _val
  FROM customers
  JOIN transactions ON customers.customer_id = transactions.customer_id
  WHERE transactions.tx_time >  '2025-03-01'
    AND transactions.tx_time <= '2025-03-31'
  GROUP BY customers.customer_id
)
SELECT u._eid AS entity_id, COALESCE(e._val, 0) AS agg_value
FROM universe u
LEFT JOIN events e ON u._eid = e._eid
İşi iki filtre yapıyor. Universe, yani sorunun evreni, kendi zaman damgası signup_date anchor'da ya da ondan önce olan müşterileri tutar; böylece gelecek ayın yeni kayıtları bu ayın sorusuna dahil olamaz. Olaylar ise (anchor + start, anchor + end] aralığındaki hedef satırlardır: burada anchor'dan sonra ve en fazla 30 gün sonrasına kadar. Hiç olayı olmayan müşteriler LEFT JOIN ve COALESCE sayesinde sıfır alır; churn için o sıfır pozitif sınıftır.
Öznitelikler aynı zaman damgasının öbür tarafından gelir. build_split ayrıca bir cutoff tablosu döndürür: her müşteri için anchor damgalı bir satır. features.py bunu Featuretools'un Deep Feature Synthesis'ine (DFS) cutoff_time olarak verir ve DFS yalnızca bu zamanda ya da öncesinde kalan satırlar üzerinden agregasyon yapar. Öznitelikler t ≤ anchor aralığını, etiketler anchor < t ≤ anchor + 30 days aralığını görür; iki pencere asla kesişmez. Tam anchor anında damgalanmış bir işlem geçmiş sayılır.
Anchor'ları da derleyici seçer. Hedef tablonun zaman aralığını okur; test anchor'ını son zaman damgasından bir tahmin ufku (burada 30 gün) önceye, eğitim anchor'ını da ondan bir ufuk önceye koyar. Model bir 30 günlük pencereden öğrenir, bir sonrakiyle notlandırılır. Örnek veritabanında bunlar 2025-04-29 ve 2025-05-29; realpath predict ikisini de yazdırır.
ADR-005'e göre her entity'ye bir anchor atanıyor. Pratikte bir split her satıra aynı anchor'ı basıyor. Featuretools satır başına ayrı bir zamanı da kabul ederdi; şimdilik bunu yalnızca RealPath'in RelBench adaptörü kullanıyor, her görev satırının kendi zaman damgasıyla.
tests/test_leakage.py dosyasının arkasındaki fikir tek cümleye sığıyor. Bir anchor'daki öznitelikler gerçekten yalnızca o anchor'da ya da öncesindeki satırlara bağlıysa, anchor'dan sonraki her satırı silmek onları değiştiremez. Test de tam olarak bunu yapıyor: o satırları siliyor.
def test_no_future_leakage(sample_db, tmp_path):
    anchor = pd.Timestamp("2025-03-01")

    X_full, _ = _build_split_and_features(sample_db, PQL, anchor)

    trunc_path = tmp_path / "trunc.duckdb"
    _truncated_db(sample_db, anchor, trunc_path)
    X_trunc, _ = _build_split_and_features(str(trunc_path), PQL, anchor)

    common_idx = X_full.index.intersection(X_trunc.index)
    common_cols = X_full.columns.intersection(X_trunc.columns)
    assert len(common_idx) > 100 and len(common_cols) > 5

    a = X_full.loc[common_idx, common_cols]
    b = X_trunc.loc[common_idx, common_cols]
    # identical => no feature depended on post-anchor rows
    mismatches = []
    for col in common_cols:
        if not _series_equal(a[col], b[col]):
            mismatches.append(col)
    assert not mismatches, f"Future data leaked into features: {mismatches}"
Test, churn özniteliklerini sentetik örnek veritabanında 2025-03-01 için üretiyor. Sonra veritabanını, zaman indeksi anchor'dan sonra olan hiçbir satırı almadan kopyalıyor ve aynı öznitelikleri kopya üzerinde üretiyor. İki matrisi ortak oldukları satır ve sütunlarda karşılaştırıyor. Sayısal sütunlar float gürültüsü payı içinde tutmalı (1e-6 göreli toleranslı np.allclose); geri kalan her şey string olarak birebir eşleşmeli.
Docstring "byte-for-byte identical" diyor, yani bayt bayt aynı; bu, assert'ün sağladığından daha güçlü bir vaat. Bence haklı olan assert: kayan noktalı agregasyonlar sana bit düzeyinde kararlılık borçlu değil. > 100 ve > 5 koruması da boş bir karşılaştırmanın geçememesini sağlıyor.
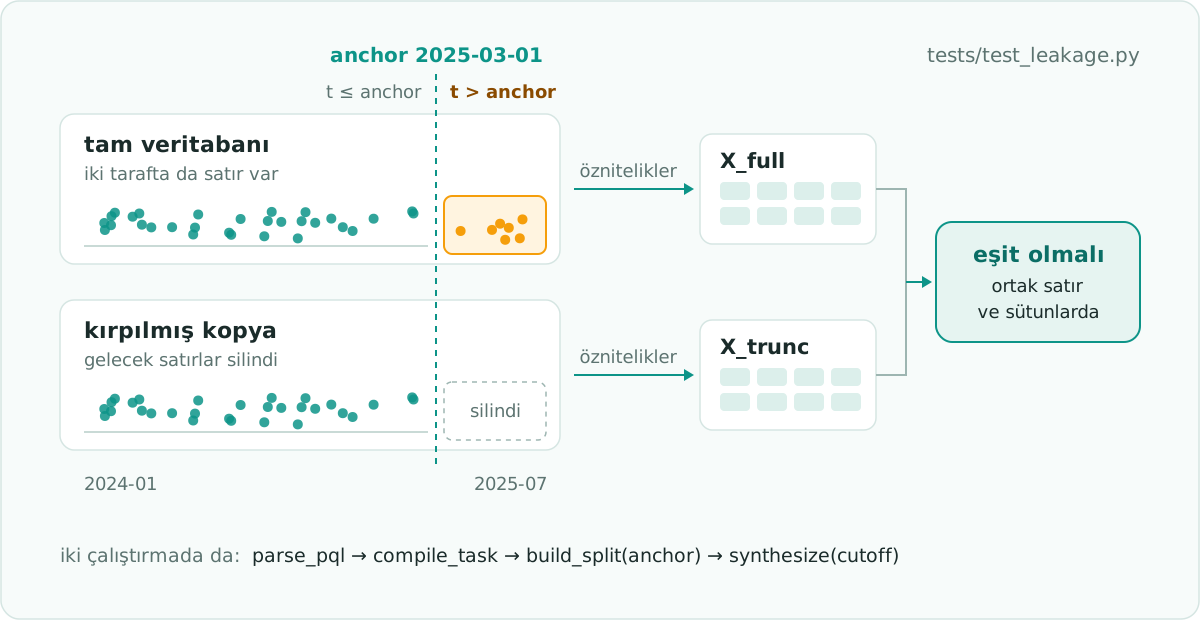
En sevdiğim şey, testin bilmedikleri: DFS'in ne olduğunu, cutoff_time parametresinin nasıl çalıştığını, hangi primitive'lerin var olduğunu bilmiyor. Yeni bir primitive, daha derin bir join yolu ya da bir kütüphane güncellemesi yarının satırlarını okumaya başlarsa, uyuşmazlık listesi o sütunları yine de adıyla sayar. Projenin tasarım spesifikasyonu (v2) daha iddialı bir şey vaat etmişti: her özniteliği kaynak satırlarına kadar izleyen bir denetçi. Hiç yazılmadı. Yazılan şey çok daha basit ve bence daha iyi: davranışa bakan bir kara kutu kontrolü.
Başarısız olamayan bir test hiçbir şey kanıtlamaz; ben de bu testi başarısız kılmaya çalıştım. Deponun geçici bir kopyasında, test edilen kodda tek satırlık değişiklikler yaptım ve her birinden sonra pytest tests/test_leakage.py koşturdum. Hiçbiri commit edilmedi ve her biri elle yeniden yapılabilecek kadar küçük:
| Tek satırlık değişiklik | pytest | Sızıntı yakalandı mı? |
|---|---|---|
| yok (yayımlandığı hâliyle) | 2 passed | — |
features.py: cutoff yok (cutoff_time=None) | 1 failed, 1 passed | evet |
features.py: cutoff anchor + 30 güne taşındı | 1 failed, 1 passed | evet |
features.py: cutoff anchor + 1 güne taşındı | 1 failed, 1 passed | evet |
compile.py: anchor'da var olma filtresi kapalı | 2 passed | hayır |
Cutoff'u kaldırınca DFS tüm veritabanı üzerinden agregasyon yaptı. Transactions ve returns üzerindeki her agregasyon değişti. Yalnızca müşterinin kendi kolonları eşleşmeye devam etti: ülke, segment ve kayıt tarihinin ayı ile haftanın günü. Cutoff'u etiket penceresinin sonuna taşımak, yani klasik off-by-one hatasının pencere boyundaki hâli, aynı listeyle başarısız oldu. Sonra en küçük değişiklik geldi, bir gün geç:
-        cutoff_time=cutoff,
+        cutoff_time=cutoff.assign(time=cutoff["time"] + pd.Timedelta(days=1)),
Hata çıktısı, satırları kaydırılmış ve kırpılmış hâliyle:
E       AssertionError: Future data leaked into features:
        ['MAX(transactions.amount)', 'MAX(transactions.quantity)',
         'MEAN(transactions.amount)', …, 'MAX(returns.transactions.amount)',
         'MEAN(returns.transactions.amount)', …]
FAILED tests/test_leakage.py::test_no_future_leakage - AssertionError: Future...
1 failed, 1 passed
Matrisi değiştirmek için bir günlük gelecek satırı yetti. Teste güvenmemi sağlayan sonuç bu oldu.
Başarısız olduğunu hiç görmediğin bir sızıntı testi kanıt değildir. Süstür.
Dördüncü değişiklik geçti. Universe filtresini, yani sonradan kaydolanları sorunun dışında tutan signup_date <= anchor koşulunu kapattım; iki test de yeşil kaldı.
Anchor'dan sonra kaydolan müşteriler artık tam veritabanının öznitelik matrisinde görünüyordu. Kırpılmış kopyada yoklar ve karşılaştırma X_full.index.intersection(X_trunc.index) üzerinden yapılıyor. Kesişim, tam da yanlış olan satırları sessizce dışarıda bıraktı. > 100 koruması boş bir karşılaştırmayı engeller, eksik bir karşılaştırmayı değil.
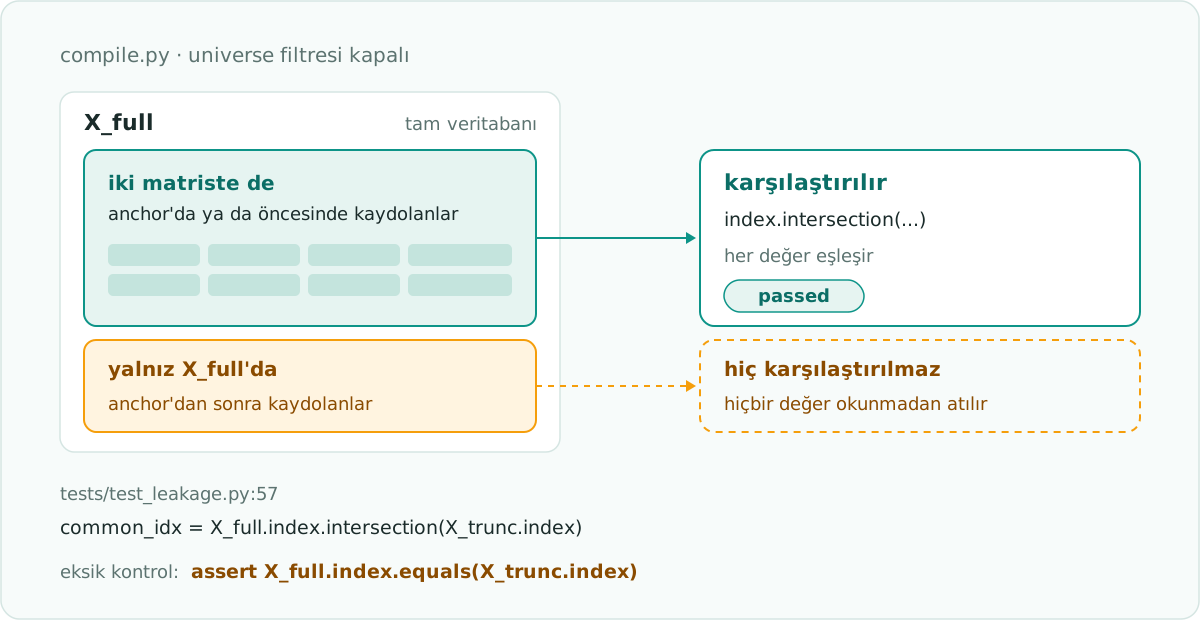
Bu bir popülasyon sızıntısı: anchor anında henüz var olmayan müşterilerle eğitim yapmak. Çözüm, herhangi bir değer karşılaştırılmadan önce gelen iki assert. Henüz depoda değiller:
assert X_full.index.equals(X_trunc.index), "entities differ: population leak"
assert X_full.columns.equals(X_trunc.columns), "feature columns differ"
İkisi de yayımlanan kodda sağlanıyor. Universe filtresi kapalıyken ilki başarısız oluyor.
İkinci açığın öznitelik koduyla hiçbir ilgisi yok. Sorun, sorunun kendisinde.
Gramer negatif pencere sınırlarını kabul ediyor (parser'ın bunun için kullandığı desen -?\d+) ve sonraki aşamalardan hiçbiri onları reddetmiyor. Ben de elle, geriye bakan bir sorgu yazdım:
PREDICT COUNT(transactions.*, -30, 0, days) == 0
FOR EACH customers.customer_id
Bu, "anchor'dan önceki 30 günde hiç alışveriş yapmamış müşteriler" diye okunur. Tahmin anında zaten bakıp görebileceğin bir bilgi; bir öngörü değil. Yine de derlendi, eğitildi ve kusursuz bir skor raporladı. realpath predict komutunun bunun için yazdırdığı çıktı, kırpılmış hâliyle:
[realpath] anchors: train=2025-06-28 test=2025-06-28
metrics: roc_auc=1.0000  accuracy=1.0000
Kusursuz skor ikinci bir hatadan geliyor. Anchor'da biten bir pencerenin ufku sıfır gün oluyor (horizon_days, abs(end) alıyor). Bu yüzden iki anchor da aynı tarihe düşüyor ve model, üzerinde eğitildiği satırlarla notlandırılıyor. Girişteki GNN ile aynı belirti: hata yok, yalnızca görünce sevindiğin bir sayı. Churn sorgusunun iki anchor'ında geriye bakan soru kusursuz olmaktan çok uzak. Ama yine de geçmişe dair bir soru.
Kırpma testi bu sorguda yeşil kalıyor, çünkü öznitelikler gerçekten temiz. Dosyadaki ikinci test, test_label_window_is_in_the_future, eksik olan özelliği assert ediyor ve bu sorguyu testin PQL sabitine koyduğumda başarısız oluyor. Ama her zaman yalnızca kendi koda gömülü sorusuyla koşuyor. Kontrol test paketinde yaşıyor; her gerçek sorgunun içinden geçtiği derleyicide değil.
Bu önemli, çünkü soruların çoğu PQL olarak gelmeyecek. RealPath İngilizce ve Türkçe soruları da kabul ediyor (ADR-007). Çevrimdışı şablonlar yalnızca ileriye bakan pencereler yazıyor; ama bir API anahtarı varsa PQL'i Claude yazıyor, parser da onu kontrol ediyor.
Model hiçbir zaman join yazmıyor ya da zaman damgası seçmiyor. Anchor, universe ve cutoff derleyiciye ait ve bu iş bölümünü hâlâ savunurum. Ama pencereyi model seçiyor. Prompt'u yalnızca ileriye bakan örnekler gösteriyor ve bir pencerenin sıfırın altında başlayamayacağını hiç söylemiyor; yeniden parse etmek de sözdizimini kontrol ediyor, zaman kipini değil. Geriye bakan bir pencere "son 30 gün" diye gelirdi ve parser'dan sonraki hiçbir şey onu durdurmazdı.
Derleyicideki tek bir kontrol iki deliği birden kapatırdı: geriye bakan pencereyi ve kusursuz skorun arkasındaki sıfır ufku:
# pql/compile.py, CompiledTask._validate(): a proposal, not in the repo
w = t.target.window
if not 0 <= w.start < w.end:
    raise PQLCompileError(
        "The label window must start at or after the anchor and end after it."
    )
Geçici bir kopyada tüm test paketi bu kontrolle de geçiyor; geriye bakan sorgu ise derleme anında duruyor.
Testin karşılaştırdığı öznitelik adları, RealPath'in açıklamalarının da hammaddesi (ADR-006). Bir DFS adı, üstüne agregasyon konmuş bir join yoludur. MEAN(returns.transactions.amount) şu demek: bu müşterinin iadeleri üzerinden, her iadenin ait olduğu işlemin tutarını al ve ortalamasını hesapla. explain.provenance(), adı yeniden tablolara ve bir agregasyona ayıran iki düzenli ifadeden ibaret; format_card() da bunu müşteri başına bir kartın tek satırı olarak basıyor.
Quickstart notebook'unun en yüksek skoru verdiği müşterinin kartındaki son satıra bak: returns -> transactions: MEAN = 148.19. Düz Türkçesiyle: bu müşterinin anchor'a kadar iade ettiği alışverişlerin ortalaması 148,19. Bu, modelin girdilerinden birinin arkasındaki hesabın birebir kendisi ve bir günlük değişikliğin bozduğu sütunlardan biri. Açıklama, testin kanıtladığı her şeyi miras alıyor.
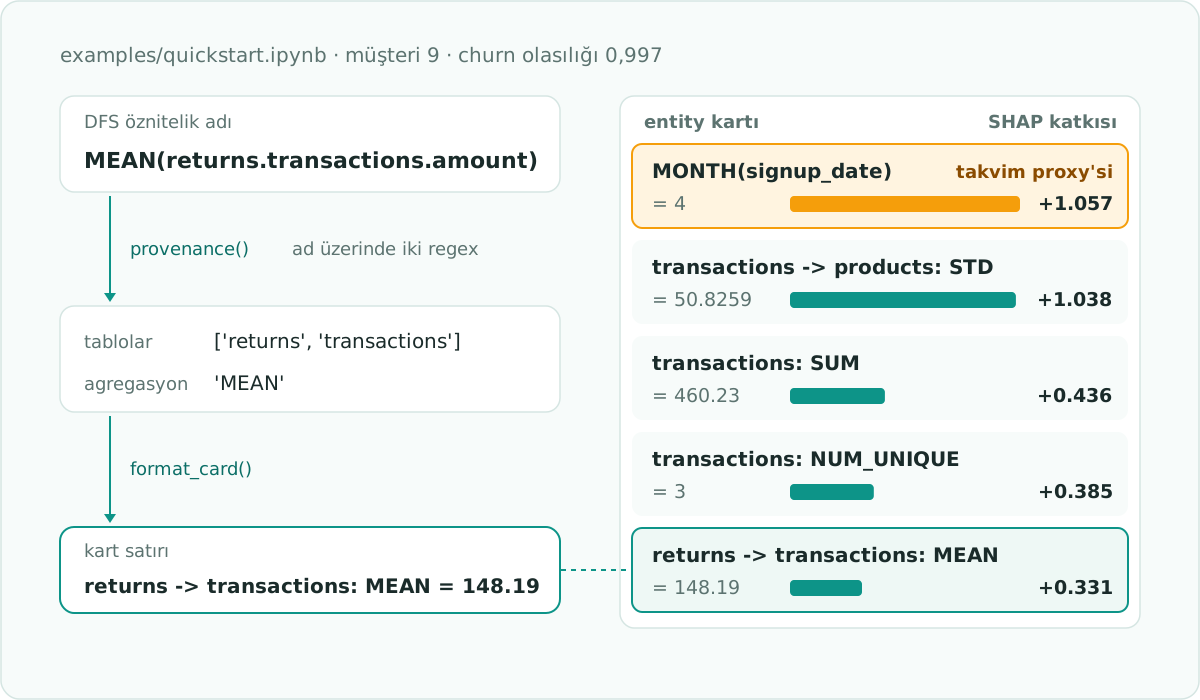
O kartla ilgili bir çekince: katkılar SHAP değerleri, çünkü notebook'un ortamında shap kuruluydu (opsiyonel explain extra'sı). Shap yoksa kart, modelin global gain değerlerine geri düşüyor ve kartta hangisine baktığını söyleyen hiçbir şey yok.
En üstteki satır ise diğer ders. Churn modelinin gain'e göre en güçlü etkeni MONTH(signup_date); oysa örnek veri üretecinde takvim ayını okuyan hiçbir şey yok. Üreteç, churn eden her müşterinin son aktif gününü kayıt tarihine göre çekiyor; yani müşterilik süresi, birinin anchor'a kadar alışverişi bırakmış olma ihtimalini kaydırıyor.
Primitive kümesinde month ve weekday var ama "kayıttan bu yana geçen gün" gibi bir şey yok. Aklıma gelen en iyi açıklama şu: ağaçlar el altındaki en yakın tutamağa yapıştı: Ocak 2024 ile Ocak 2025'i ayırt edemeyen bir takvim alanına. Yine de gain sıralaması nedensel bir sıralama değil ve 12 seviyeli bir kategorik değişken gain toplamaya meyillidir.
Bir sızıntı testi, modelin yalnızca geçmişi gördüğünü kanıtlar. Modelin o geçmiş hakkında gerçek bir şey öğrendiğini kanıtlayamaz; notebook'un sentetik veride aldığı 0,7492 ROC-AUC da bunu bana asla göstermezdi.
Yukarıdaki iki açık bir yana:
- Silinen satırları görüyor, güncellenenleri değil. Kırpma, satırları zaman indeksine göre kaldırıyor; zaman indeksi olmayan bir tablo (örnekte
products) olduğu gibi kopyalanıyor. Gerçek bir veritabanında yerinde üzerine yazılmış bir fiyat ya da segment, geçmiş kılığına girmiş bugünkü değerdir. Ne kadar silersen sil, onu ortaya çıkaramazsın. Bunun için snapshot'lar ya da geçmiş tabloları gerekir. - Test ettiği zaman indeksine güveniyor. Kırpma da cutoff da RealPath'in her tablo için çıkardığı ilk zaman damgası kolonunu kullanıyor (ADR-010). Bu tahmin yanlışsa iki taraf da aynı hatayı paylaşır ve karşılaştırma onu göremez.
- Split'e bakmıyor. Test tek bir anchor'ı sabitliyor. Eğitimle skorlamanın farklı anchor'lar kullandığını kontrol eden hiçbir şey yok; geriye bakan sorgu kendi kendini tam da böyle notlandırdı.
- Tek bir durumu kanıtlıyor. Tek anchor, tek sorgu, tek sentetik veritabanı. Testi şablonlar ve birkaç anchor üzerinden parametrelemek ucuz olurdu.
- Yalnızca pytest'in koştuğu yerde koşuyor. ADR-005 bu özelliği CI'ın kanıtlayacağını varsayıyor, ama bu hesapta GitHub Actions hiç koşmadı (ADR-015). Kapı, yerel bir koşu.
Girişteki GNN de hâlâ adil bir koşu bekliyor. ADR-011 her karşılaştırmanın temporal ya da leaky olarak etiketlenmesini istiyor; bu yüzden onun 0,76'sı benchmark tablosunun dışında kalıyor. Yerel bir Linux container'ı diski doldurdu. Sonraki plan bir CI workflow'uydu: yazıldı ama Actions'ın koşmadığı bir hesapta hiç etkinleştirilmedi. Karar günlüğü ve handover artık adil sayıyı PENDING olarak işaretliyor; benchmark sayfası ise hâlâ CI'ı gösteriyor.
Bu desen Featuretools'a ya da RealPath'e özgü değil. Zaman damgalı satırlardan öznitelik üreten her pipeline aynı denetimi koşturabilir.
RealPath, MIT lisansıyla GitHub'da: Ozgurisikdamar/RealPath. PyPI'da yayımlanmadı; bu yüzden klonlayıp kur:
git clone https://github.com/Ozgurisikdamar/RealPath.git && cd RealPath
python -m venv .venv && source .venv/bin/activate
pip install -e ".[dev]"
pip install "setuptools<81"
python -m pytest tests/test_leakage.py -q
Python 3.12+ sürümünde ya da uv ile kurulmuş bir ortamda venv'de setuptools bulunmuyor; woodwork (Featuretools'un bir bağımlılığı) ise hâlâ pkg_resources import ediyor. Sürüm sabitlemesinin sebebi bu; 3.10 ve 3.11'de zararsız. Tablodaki değişiklikler realpath/features.py ve realpath/pql/compile.py içindeki tek satırlık düzenlemeler. Geriye bakan sorgu olduğu gibi çalışıyor:
realpath make-sample
realpath predict "PREDICT COUNT(transactions.*, -30, 0, days) == 0
  FOR EACH customers.customer_id" --db data/shop.duckdb
"Sızıntı yok" gelecek hakkında bir iddia; o hâlde onu geleceği silerek test et. Sonra kendi cutoff'unu, test kırmızıya dönene kadar boz. Matrislerin kesişimini değil, tamamını karşılaştır. Yön kontrolünü de yalnızca testinin tesadüfen sorduğu soruya değil, her gerçek sorunun içinden geçtiği yere koy. O zamana kadar "sızıntı yok" hâlâ bir slogan. Sadece yanında yeşil bir onay işareti var.
Dipnotlar
-
0,76
docs/HANDOVER.mddosyasında, yaklaşık 0,72'lik referansdocs/BENCHMARKS.mddosyasında kayıtlı. Yayımlanan öznitelik sentezi pipeline'ı aynı görevde 0,592 alıyor, daha derin özniteliklerle 0,658. Bu yazı için RelBench yolunu yeniden koşturmadım. ↩