12 dk okuma
İki kez koşturmak zorunda kaldığım kilitli holdout — ve iki koşuyu da neden herkese açık tuttum
Kilitli test setim iki kez koştu: tek bir alan 1.151 soruyu manşet skorundan saklamıştı. Veriyi düzelttim, modelin yerinden kıpırdamadığını kanıtladım ve iki koşuyu da yayımladım.
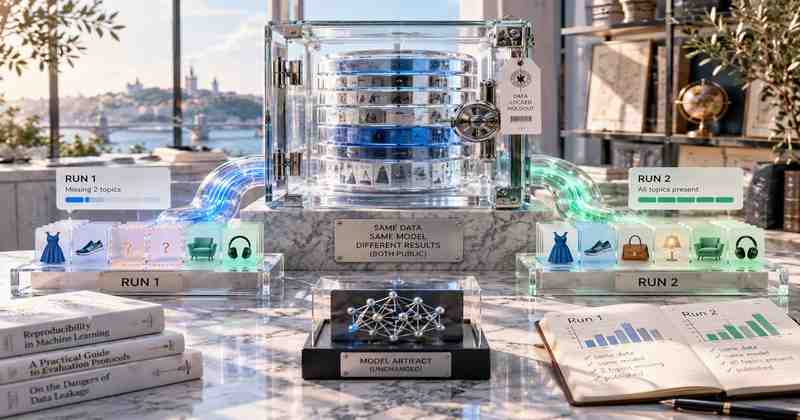
ContextLens için yalnızca bir kez koşmasına izin verilen bir değerlendirme kurmuştum. İlk koşunun Wikipedia sonuçları, geliştirme sırasında gördüklerimle uyumlu geldi. Stack Exchange'deki manşet skoru ise hiçbir modelin yanılamayacağı biçimde yanlıştı: 472 soruyu kapsıyordu ve bunların tek biri bile Teknoloji ya da Bilim sitelerinden gelmiyordu — oysa o skorun arkasındaki on bir siteden dördü yapay zekâ, yazılım mühendisliği, kuantum hesaplama ve bilim tarihi üzerine.
Model sekiz konusundan ikisini unutmamıştı. Onları, test setinin görünümlerinden biri kaybetmişti.
ContextLens, sohbetler için yerel bir konu analizcisi: her İngilizce mesaja 8 genel konudan biri ve 28 alt konu arasından birincil bir alt konu atanıyor; konu dışı bir mesajın cevabı ise uncertain. Bu yazı onun nihai test setini — yalnızca bir kez bakma hakkın olan seti — ve o set bozuk döndüğü gün yaptıklarımı anlatıyor: veriyi çevrimdışı düzelttim, modelin yerinden oynamadığını kanıtladım, yeniden dondurdum, yazılı bir gerekçeyle yeniden koşturdum ve bozuk koşuyu sağlam olanın yanında yayımladım.
Sürüm 1.0'da test bölümleri vardı. Bu sürüm için yapılan bir denetim, sorunu dört kelimeyle adlandırdı: no untouched final holdout, yani dokunulmamış bir nihai holdout yok. O bölümler geliştirme sırasında hesaplanmış, seçimler hâlâ yapılırken benchmark tablolarında boy göstermişti. Bir şeyleri seçerken baktığın sayı artık kör değildir.
Bu yüzden v1.1 için hiçbir geliştirme betiğinin okumadığı veriler oluşturdum ve bunları v1.1 modeli seçilip eğitilmeden önce commit ettim:
- Korpusun hiçbir sürümünde yer almayan makalelerden 374 Wikipedia pasajı. Veriyi kuran betik, etiket manifestinin yalnızca güncel sürümüne değil, git geçmişinde commit edilmiş her sürümüne bakıyor.
- 1 Ocak ile 20 Eylül 2026 arasında sorulmuş 2.713 Stack Exchange sorusu. v1.0 setleri MTEB kümeleme başlıklarından ve API üzerinden çekilmiş, tüm zamanların en çok oy alan sorularından oluşuyordu; bu yüzden 2026 penceresi çoğunlukla yeni sorular getiriyor. Zaten bir değerlendirme setinde bulunan her soru da ayıklandı.
- Konu dışı sohbet için 4.350 CLINC150 test ifadesi — CLINC'in kendi
oossınıfı ve konu içi sayılabilecek beş intent hariç — ve dil kapısı için bir Tatoeba setinin kilitli yarısı.
Bir manifest, kurulan iki dosyanın satır sayısını ve SHA-256'sını kaydediyor; CLINC150 ile Tatoeba'nın kilitli yarıları için de birer hash tutuyor. Ardından kilit geliyor. scripts/freeze.py, takip edilen dosyalarda commit edilmemiş bir değişiklik varsa çalışmayı reddediyor ve reports/locked/FREEZE.json dosyasını yazıyor: commit'i, çalışma zamanı ayarlarını ve altı dosyanın SHA-256'sını. Bu altı dosya model yapılandırması, taksonomi, çalışma zamanı yapılandırması, eğitim pasajları, kilitli manifest ve artefaktın metadata.json dosyası; sonuncusu da her model dosyası için, tek tek encoder ağırlık dosyalarına kadar inen bir checksum tutuyor. Yani tek bir hash, eğitilmiş modelin tamamını temsil ediyor. evaluate.py --stage locked modeli yüklemeden önce bunların hepsini kontrol ediyor:
def check_freeze(model_dir: Path, rerun_reason: str | None) -> dict:
    freeze_path = LOCKED_DIR / "FREEZE.json"
    if not freeze_path.exists():
        raise SystemExit("no reports/locked/FREEZE.json - run scripts/freeze.py before the locked evaluation")
    freeze = json.loads(freeze_path.read_text(encoding="utf-8"))
    now = freeze_fingerprint(model_dir)
    changed = [k for k, v in freeze["files"].items() if now.get(k) != v]
    if changed:
        raise SystemExit(f"configuration changed since the freeze: {changed}")
    results = LOCKED_DIR / "results.json"
    if results.exists() and not rerun_reason:
        raise SystemExit("the locked holdout was already evaluated; pass --rerun-reason to record a second run")
    return freeze
Üç ret: freeze dosyası yoksa, parmak izi değiştiyse ya da gerekçesiz ikinci bir koşu isteniyorsa. Sonuncusu bir formalite gibi duruyor. Oysa bu yazının tamamı, o satırın tam da kendisi için yazıldığı durumu anlatıyor — ve sonunda o satır hiç tetiklenmedi.
Stack Exchange soruları iki ayrı değerlendirmeye hizmet ediyor; hata da tam orada yaşıyordu.
Genel konu görünümü, modelin genel konuyu doğru bulup bulmadığını soruyor. On bir sitenin her sorusu, sitesine göre etiketleniyor: physics ve astronomy Fizik; ai, softwareengineering ve quantumcomputing Teknoloji; hsm (bilim ve matematik tarihi) Bilim.
Alt konu görünümü aynı soruyu alt konu için soruyor. Buradaki sorular (site, tag) sorgularından geliyor — quantum-mechanics tag'li physics soruları Kuantum Mekaniği sayılıyor — ve dört alt konu, hiçbir tag olmadan doğrudan bir sitenin tamamına bağlanıyor: yapay zekâ (ai), yazılım (softwareengineering), kuantum hesaplama (quantumcomputing) ve bilim tarihi (hsm).
Bir soru genel konu görünümünde, alt konu görünümünde, ikisinde birden ya da hiçbirinde olabilir. Bunlar birbirinden bağımsız iki olgu. Kurulum betiği ise ikisini tek bir değere sıkıştırmıştı:
# scripts/build_locked_sets.py as it was for run 1 (removed in commit 9613200)
# runs for every (site, tag) query of every subtopic; g is its general topic
row = rows.setdefault(
    key, {**q, "set": "subtopic", "general": g.id, "subtopics": [], "is_ood": False}
)
row["set"] = "subtopic" if row["set"] == "subtopic" or row["general"] == g.id else row["set"]
Önce genel konu siteleri çekildi ve soruları general olarak işaretlendi; ardından alt konu sorguları geldi. İlk kez orada görülen bir soru subtopic olarak işaretlendi; zaten general olarak kaydedilmiş bir soru da konular her eşleştiğinde subtopic'e çevrildi. Hangi yoldan olursa olsun, on bir siteden birinden gelen soru genel konu görünümünün dışında kaldı; oysa sitesi onun orada olması gerektiğini söylüyordu.
Sorusu tamamen gitmeyen altı sınıf, sorularının %31'i ile %75'i arasında bir kısmını kaybetti; Fizik'in 653 sorusundan geriye 164'ü kaldı. Siteyi bütünüyle kapsayan dört alt konuda ise soruların hepsi gitti, çünkü alt konu sorgusu site sorgusunun ta kendisiydi: aynı site, aynı tarihler, aynı sıralama, tag yok. Genel sorgunun kaydettiklerinin tıpatıp aynısını döndürdü ve hepsi çevrildi: birinci koşunun kilitli dosyasında ai, softwareengineering, quantumcomputing ve hsm sitelerinden gelen 399 sorunun tamamı "set": "subtopic" taşıyor. Bu dört site, genel konu görünümünde Teknoloji ve Bilim sınıflarının tamamını oluşturuyor; sıfıra inenlerin tam olarak bu iki sınıf olması bundan.
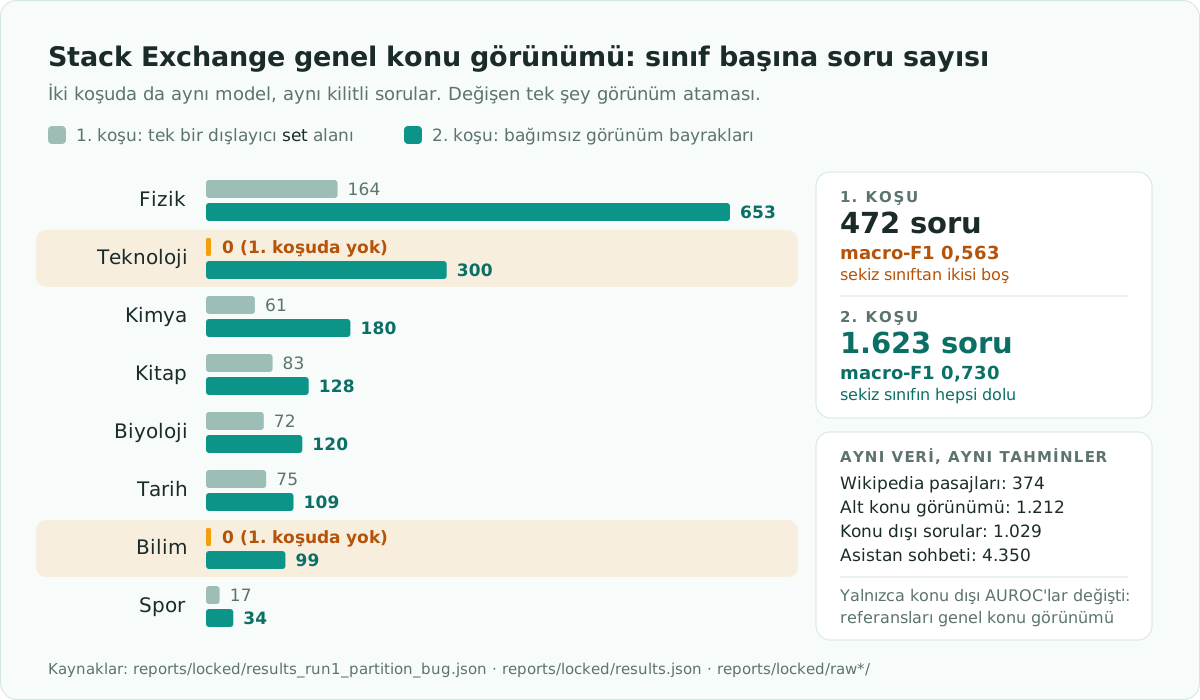
Birinci koşu o soruları aslında puanladı, yalnızca öbür görünümde: aynı koşu, aynı modelle, alt konu görünümündeki 317 Teknoloji sorusunda 0,862 F1 ölçtü.
Hiçbir şey çökmedi, manşet de saçma değildi: doğruluk 0,735, macro-F1 0,563. Bu, zayıf bir modelin skoru gibi duruyor. Oysa iki boş sınıfı da içeren bir ortalamaydı: sorusu olan altı sınıfta macro-F1 0,751'di; Teknoloji ve Bilim ortalamaya sıfır olarak girmişti.
Ele veren şey verinin şekliydi: 472 soru ve hiç örneği olmayan iki sınıf; oysa gerçek sorulardan oluşan geliştirme setinde (ext_dev) 1.500 Teknoloji ve 951 Bilim sorusu var. Üstelik hasar yayıldı. İki konu dışı AUROC da alan içi referans olarak genel konu görünümünü kullanıyor, bu yüzden ikisi de oynadı: asistan sohbetinde 0,942 → 0,961, konu dışı Stack Exchange sitelerinden gelen sorularda 0,838 → 0,886. Tek bir bozuk görünüm yetti; onun üzerine kurulan her sayı yanlıştı.
Onarımın tek bir kısıtı vardı: hiçbir soruyu, hiçbir etiket kuralını ve modeldeki hiçbir şeyi değiştirmemek; yalnızca her sorunun hangi görünüme ait olduğunu değiştirmek. Yeni bir tanıma da gerek yoktu. Onarım, v1.0 genel setinin baştan beri kullandığı kuralı geri getirdi: sitesi genel konu görünümündeyse soru da oradadır ve etiketini sitesi verir. Alt konu görünümü set alanını zaten hiç okumamıştı; o görünüm her zaman, taksonomi içinde kalıp bir alt konusu olan soruların tamamından oluşuyordu. Dolayısıyla genel konu görünümünün yalnızca kendine ait bir bayrağa ihtiyacı vardı:
for r in rows:
    r.pop("set", None)
    r["in_general"] = r["site"] in site_general or r["site"] in ood_sites
    r["site_general"] = site_general.get(r["site"])
Konu dışı siteler genel konu görünümüne etiketsiz katılıyor; konu dışı değerlendirmesinin negatif örnekleri onlar. Yeni --repair modu, bayrakları kaydedilmiş se_locked.jsonl dosyasından tek bir ağ isteği atmadan yeniden türetiyor; yani hiçbir soru yeniden çekilemez, eklenemez ya da kaybolamazdı. Değerlendirme tarafında tek bir satır değişti: genel konu görünümü artık in_general bayrağı taşıyan her soru ve etiketini sitesi veriyor.
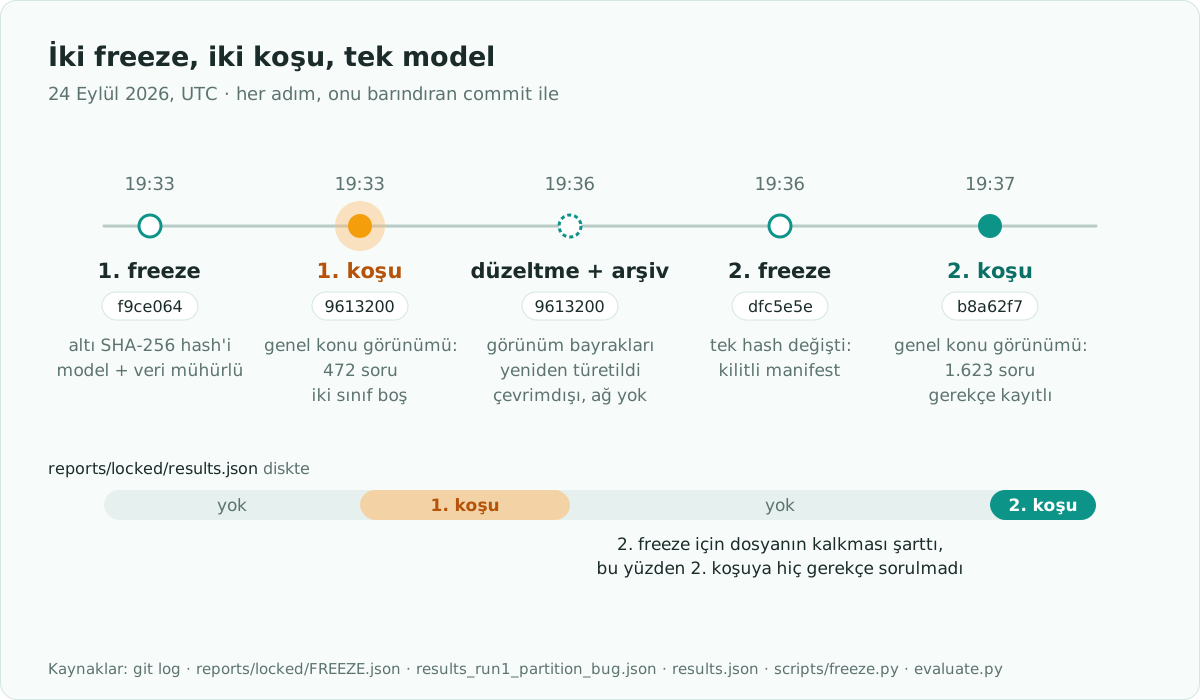
Birinci koşu ortadan kaybolmadı. Sonuçları reports/locked/results_run1_partition_bug.json adıyla, ham tahminleri ve _run1 grafikleriyle yan yana commit edildi; ne olduğunu da karar günlüğündeki D-36 anlatıyor. Sonra yeniden dondurdum. İki freeze arasındaki farkın tamamı şu; değişmeyen satırları kırptım, hash'leri on iki karaktere kısalttım:
# git show dfc5e5e -- reports/locked/FREEZE.json
-  "frozen_at": "2026-09-24T19:33:30+00:00",
-  "commit": "f0f1b0638887…",
+  "frozen_at": "2026-09-24T19:36:51+00:00",
+  "commit": "96132001674c…",
-    "data/locked/MANIFEST.json": "78f3cb1b90ec…",
+    "data/locked/MANIFEST.json": "30a2f6d55aac…",
     "models/contextlens-topic/metadata.json": "daf72ce77472…"
Commit ve zaman damgası değişti; manifest de değişti, çünkü kilitli dosyanın içindeki görünüm bayrakları değişmişti. Metadata hash'i ise değişmedi — ve o hash, modelin kendisi.
İkinci koşu aynı parmak izi kontrolünden geçti ve sonuç dosyası ortada neden bir ikinci koşu olduğunu da söylüyor — bölümleme hatası düzeltildikten sonra, model ve yapılandırma değişmeden: "run 2 after fixing the locked Stack Exchange view partition bug (D-36); model and configuration unchanged".
En güçlü kanıt ham tahminlerde. Wikipedia dosyası ve iki konu dışı dosya, iki koşuda bayt bayt aynı. Birinci koşunun genel konu görünümünde puanladığı 472 sorunun hepsi, ikinci koşuda aynı tahmin etiketiyle, aynı güvenle ve aynı uncertain bayrağıyla yeniden karşımıza çıkıyor; yalnızca 100 tanesinin konu dışı skoru oynuyor, o da en fazla milyonda iki kadar. Bu, aynı metinler farklı batch'lerde embed edildiğinde ortaya çıkan kayan nokta gürültüsü. İkinci koşu modeli farklı puanlamadı. Fazladan 1.151 soru puanladı: birinci koşunun genel konu görünümünün dışında bıraktığı soruları.
Beni birinci koşuyu yayımlamaya zorlayan hiçbir şey yoktu. Bir veri hatasıydı, model hiç değişmemişti ve tek bir dosyayı silmek daha derli toplu bir hikâye bırakırdı. Üç sebeple kaldı.
İddiayı sınanabilir kılıyor. "Model iki koşu arasında değişmedi" cümlesi, dikkatli bir okurun tam da şüpheyle bakması gereken cümle; çünkü sayı daha iyi görünene kadar sessizce yeniden koşturan birinin yazacağı cümle de bu. İki koşu da commit edilmişken kimsenin benim sözüme güvenmesi gerekmiyor.
Hatayı, düzyazının yapabileceğinden daha iyi belgeliyor. Birinci koşunun 472 sorusu ve iki boş sınıfı, ikinci koşunun 1.623 sorusu ve sekiz dolu sınıfıyla yan yana konunca, dışlayıcı bir alanın bir veri setine ne yaptığını tek bir tabloda gösteriyor.
Korumalar beni durduramazdı. freeze.py, reports/locked/results.json diskte dururken yeni bir freeze yazmayı reddediyor ve mesajı nedenini de söylüyor: "a new freeze would hide that", yani yeni bir freeze bunu gizlerdi. Yeniden dondurabilmek için birinci koşunun sonuçlarını kenara taşımam gerekti; yeni adlarıyla, kurulum betiğini düzelten commit'in içine girdiler. Bu taşıma yeniden koşu korumasını da devre dışı bıraktı: diskte results.json yokken evaluate.py gerekçe sormuyor. Ben yine de --rerun-reason verdim. Korumalar bir kazayı durdurur; bir kararı durduramaz. İkinci koşuyu meşru kılan, etrafındaki kayıt: arşiv bir commit, gerekçe JSON'un içinde, karar günlüğünde D-36 var ve KNOWN_ISSUES.md "Locked evaluation was run twice" (kilitli değerlendirme iki kez koşturuldu) maddesini 12 numaralı sorun olarak listeliyor: önem derecesi düşük, açıklanmış.
Mühür küçük şeylerde de katı. Kilitli koşudan sonra GitHub deposunun adını bir kez daha, ContexLens olarak değiştirdim; ama web araması User-Agent'ında hâlâ aradaki adı, ContexLens-NLP'yi gönderiyor (GitHub eski adları yönlendiriyor). Bu değer parmak izi alınan bir dosyada, contextlens/config.py içinde duruyor ve kozmetik bir URL için freeze bozmaya değmez.
Sessizce yeniden koşturabildiğin bir holdout, görgüsü biraz daha iyi bir doğrulama setinden ibarettir.
Mühürlü bir test seti, mühürden önce yapılan seçimleri onaylar. O seçimleri yanlış veriyle yaparsan kilit, yanlış cevabı istifini hiç bozmadan onaylar.
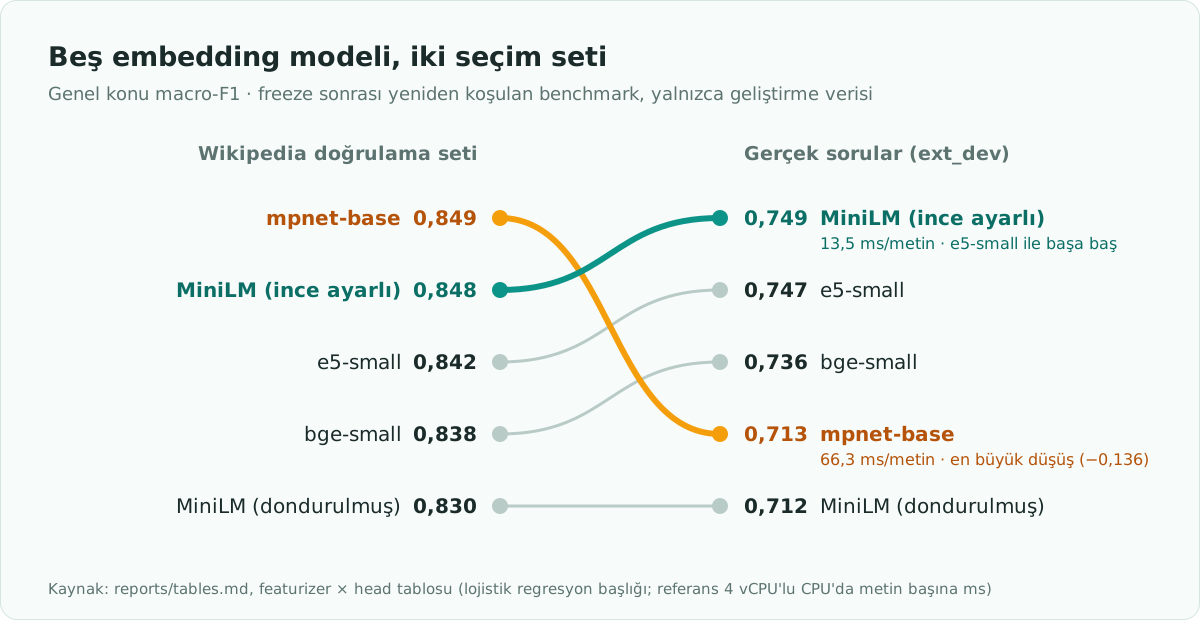
ContextLens hiperparametreleri Wikipedia doğrulama setinde ayarlıyor, ama model ailelerini doğrulama setinde ve gerçek Stack Exchange sorularında (ext_dev) seçiyor; çünkü kullanıcılar ansiklopedi paragrafı değil, kısa sorular yazıyor. Bu projede ikinci set birincinin kararını hiç bozmak zorunda kalmadı: encoder'ı v1.0 etiketleriyle seçtiğimde ince ayarlı MiniLM ikisinde de öndeydi. Nihai korpus üzerinde, freeze'den sonra ve yalnızca geliştirme bölümleriyle yeniden koşulan benchmark ise ikinci setin neye karşı sigorta olduğunu gösteriyor:
| genel konu, macro-F1 | Wikipedia doğrulama | gerçek sorular | ms / metin | MB |
|---|---|---|---|---|
| mpnet-base (dondurulmuş) + LR | 0,849 | 0,713 | 66,3 | 437,9 |
| e5-small (dondurulmuş) + LR | 0,842 | 0,747 | 25,3¹ | 133,4 |
| MiniLM (ince ayarlı) + LR | 0,848 | 0,749 | 13,5 | 90,9 |
¹ Boşta bekleyen bir makinede yeniden ölçüldü; benchmark koşusu e5-small'ı yük altındayken yakalamıştı.
Wikipedia'da ilk ikisi berabere ve beraberlik seçim yapamaz: argmax, yaklaşık beş kat daha yavaş ve daha büyük olan mpnet-base'i seçiyor. Gerçek sorularda beraberlik bozuluyor, üstelik bunun tek sebebi ince ayar değil — sadece dondurulmuş encoder'lara bakıldığında bile mpnet-base, Wikipedia'daki birincilikten, boyutu onun üçte biri kadar olan e5-small ile bge-small'ın gerisine düşüyor. Kalibrasyonda ise iki sette de ince ayarlı MiniLM'i geçiyor; ama protokolde kalibrasyon, eşitliği bozan ölçütlerin sonuncusu. Ondan önce gecikmeye ve boyuta bakılıyor, o ikisi de öbür yönü gösteriyor. Model raporu bunu tek satırda özetliyor: yalnızca Wikipedia'ya bakarak seçmek, yanlış ve en yavaş modeli seçtirirdi.
Bunlar ikinci koşunun sayıları; projenin raporladıkları da bunlar:
| kilitli set | n | doğruluk | macro-F1 | ECE |
|---|---|---|---|---|
| Wikipedia, görülmemiş makaleler | 374 | 0,8476 | 0,8382 | 0,0579 |
| Stack Exchange soruları, 2026 | 1.623 | 0,8035 | 0,7304 | 0,0560 |
| aynısı, bilim tarihi sitesi olmadan | 1.524 | 0,8432 | 0,8178 (7 sınıf) | – |
Konu dışı kapısı, CLINC150 asistan sohbetinin %78,1'ine uncertain diyor (AUROC 0,961), ama konu dışı Stack Exchange sitelerinden gelen soruların yalnızca %48,5'ine (AUROC 0,886). Bir mesaj da 4 vCPU'lu bir makinede medyan 19,9 ms sürüyor.
Zayıf nokta ortada: genel konu görünümündeki gerçek sorularda Bilim sınıfının F1'i 0,241. O görünümdeki 99 Bilim sorusunun hepsi hsm'den geliyor ve %42,4'ü Fizik olarak tahmin ediliyor — "Why Euler didn't include viscosity in equations of fluid dynamics?" (Euler akışkanlar dinamiği denklemlerine viskoziteyi neden katmadı?) sorusu 0,963 güvenle Fizik'e gidiyor. Taksonomi 1.2.0'dan beri Bilim, bilimsel faaliyetin kendisi demek: yöntem, araştırma pratiği, başlı başına bilim tarihi. Dolayısıyla o sorunun Fizik olduğu savunulabilir; hsm de sessizce dışarıda bırakılmak yerine ayrıca raporlanıyor. Projenin kendi kuralı Bilim'i alt konu görünümündeki sorularla ölçüyor; orada 143 soruda 0,420 alıyor. Yapmadığım şey ise kilidin tam da önlemek için var olduğu şey: 0,241'i görüp geri dönmek ve onu ayarlayarak yukarı çekmek. Bir alanın tarihine dair sorular için ikinci bir genel konu (örneğin "Fizik + tarih") backlog'da; v1 için açıkça planlanmıyor.
- Anahtarı bende olan bir kilit. Parmak izi, dosyaların freeze ile koşu arasında değişmediğini kanıtlıyor; kilitli dosyaları başka bir yoldan hiç açmadığımı değil. Arkasında duran şey herkese açık commit geçmişi, geçmiş ise ispat değil, delildir: bu deponun geçmişi v1.1'den önce, yerini yenisine bırakmış bir model artefaktını çıkarmak için bir kez yeniden yazıldı ve bunu da bir commit kayıt altına alıyor.
- Onu kendiliğinden yeniden denetleyen bir şey yok. CI workflow'u yalnızca elle tetikleniyor, adımları yerelde
scripts/ci.shile koşuyor ve commit edilmiş dosyalarıFREEZE.jsonile karşılaştıran bir test yok. - Setler küçük. Genel konu başına 29 ile 60 arası Wikipedia pasajıyla tek bir sınıfa ait sayılar geniş bir belirsizlik taşıyor; üç alt konunun — periyodik tablo, kuantum hesaplama, bilimsel yöntem — ise hiç kilitli Wikipedia pasajı yok.
- Manşet tablosu birinci koşudan söz etmiyor. README'deki kilitli tablo "evaluated once after the freeze" (freeze'den sonra bir kez değerlendirildi) diyor. D-36'yı ya da bilinen sorunlar listesini hiç açmayan bir okur birinci koşuyu görmez; oysa açıklama sayının hemen yanında durmalı.
- Bu yazı için hiçbir şey yeniden koşturulmadı. Buradaki her sayı commit edilmiş dosyalardan geliyor. Yazarken hesapladığım şeyler yalnızca şunlardı: değişmeyen tahmin dosyalarının bayt düzeyinde karşılaştırması, 472 sorunun satır düzeyinde eşleştirilmesi ve commit edilmiş dosyalar üzerinde yaptığım sayımlar.
- Kilitli seti, yargılayacağı kararlardan önce kur ve commit et.
- Sistemi tanımlayan her şeyin, modelin kendi checksum'ları dahil, parmak izini al; en küçük uyuşmazlıkta çalışmayı reddet.
- Grup üyeliğini bağımsız bayraklar olarak tut ve tek bir skor hesaplamadan önce sınıf başına örnek sayısını kontrol et.
- Yeniden koşturman gerekirse: çevrimdışı düzelt, yeniden dondur, bozuk koşuyu arşivle ve araçlar sormasa bile gerekçeyi sonuçların içine yaz.
- Açıklamayı insanların alıntıladığı tabloya, sayının hemen yanına koy.
Karar günlüğü, iki sonuç dosyası ve iki koşunun ham tahminleri, Apache-2.0 lisansıyla ContexLens deposunda duruyor.
Kilitli bir holdout, onu asla iki kez koşturmayacağına dair bir söz değildir. Koşturursan, nedenini herkesin görebileceğine dair bir sözdür. Mührü veri yanlış olduğunda kır, sayı yanlış göründüğü için asla — ve bozuk koşuyu herkesin okuyabileceği bir yerde bırak.